 scopal affairs
Intergalactic Frequencies
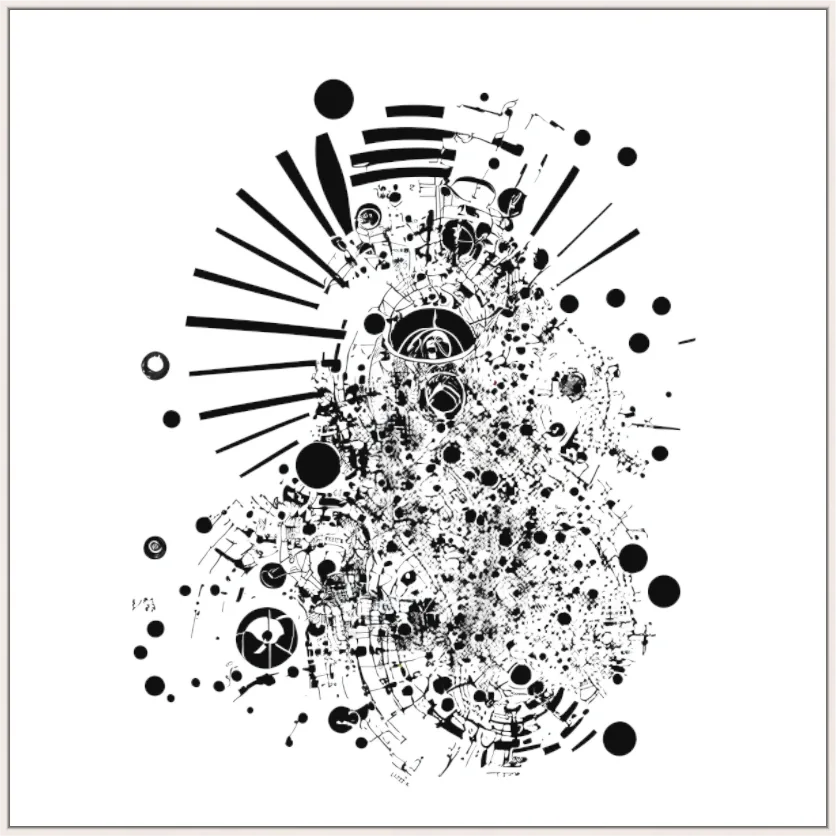
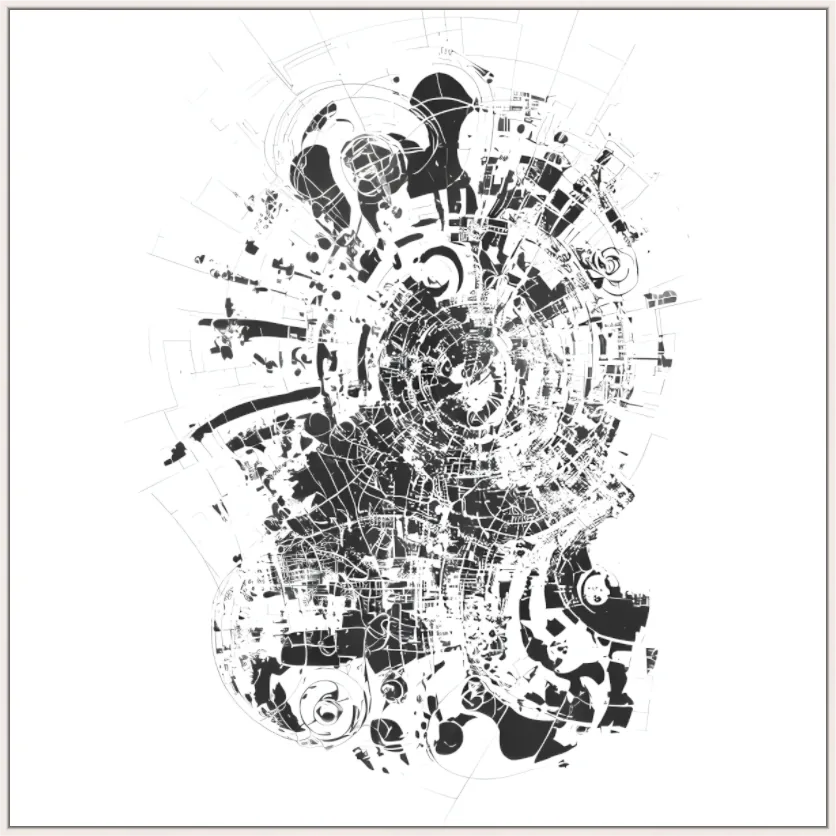
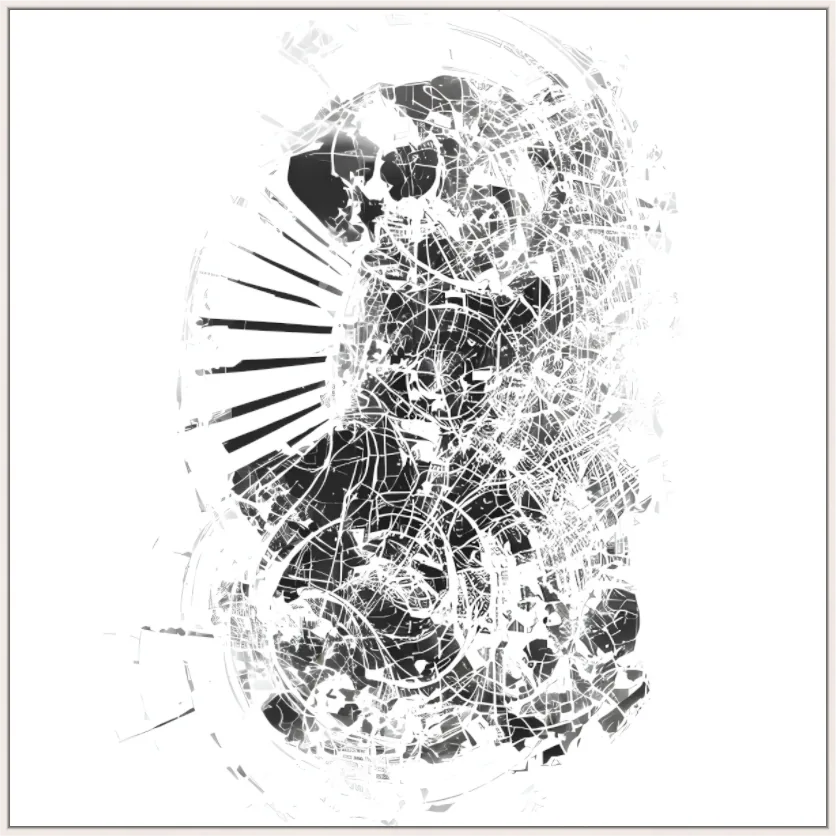
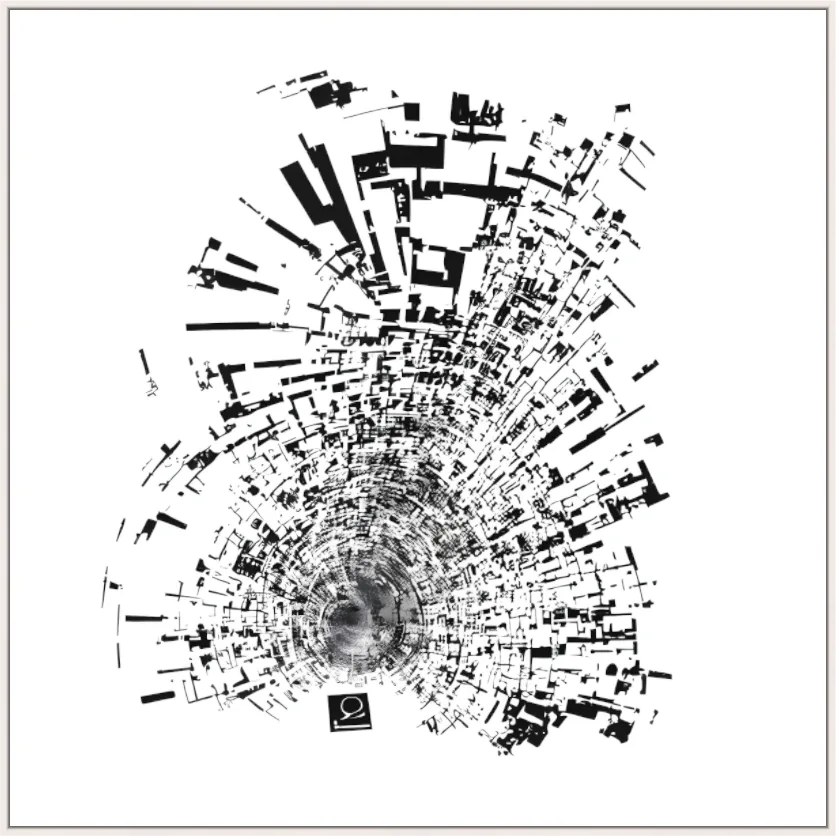
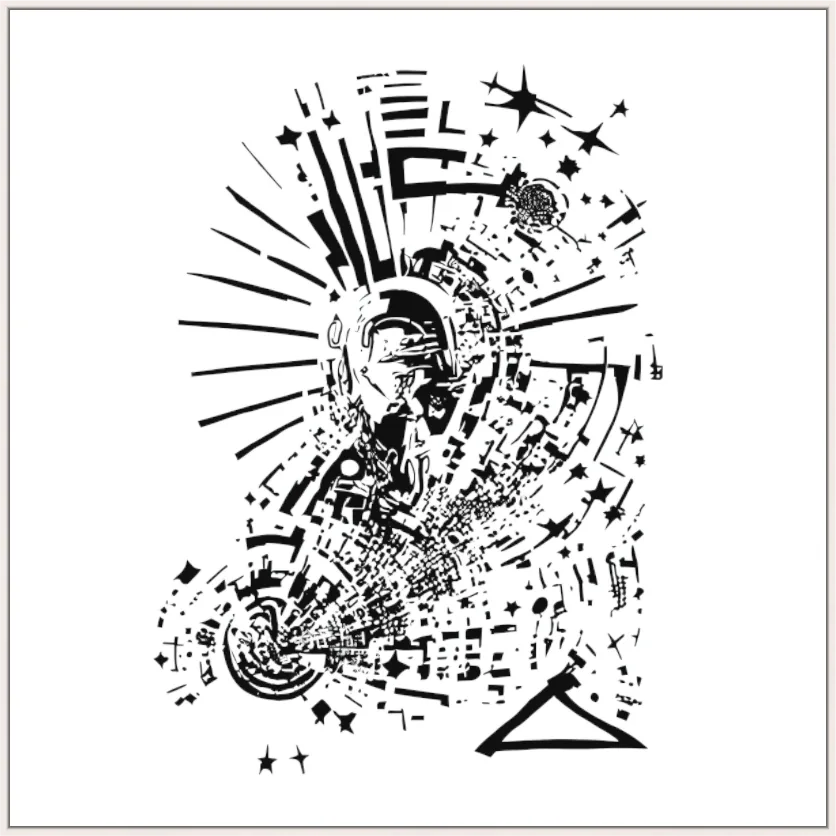
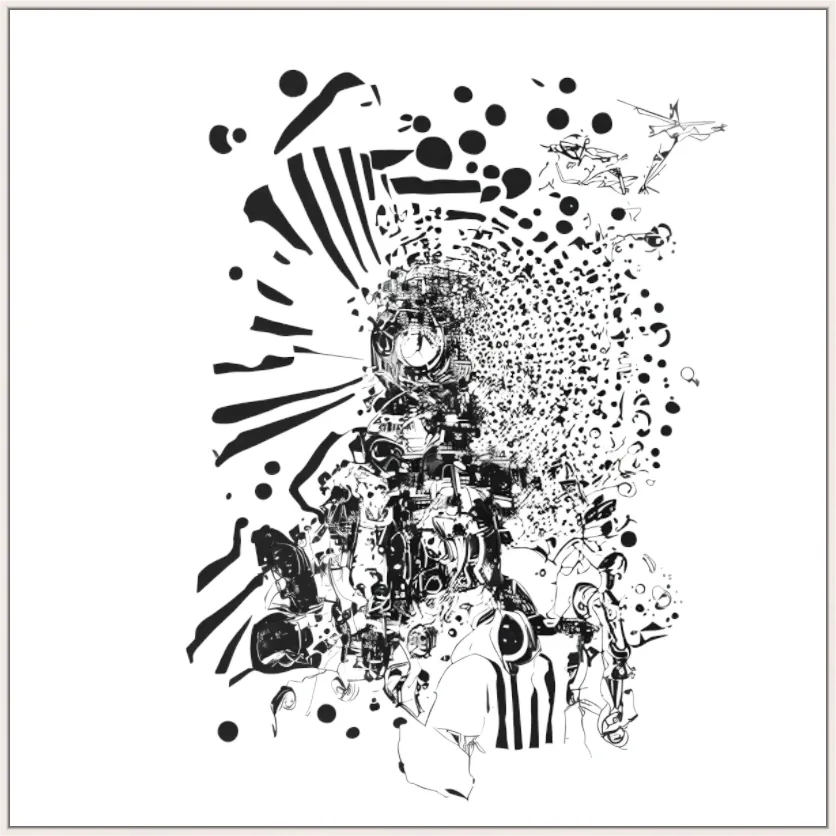
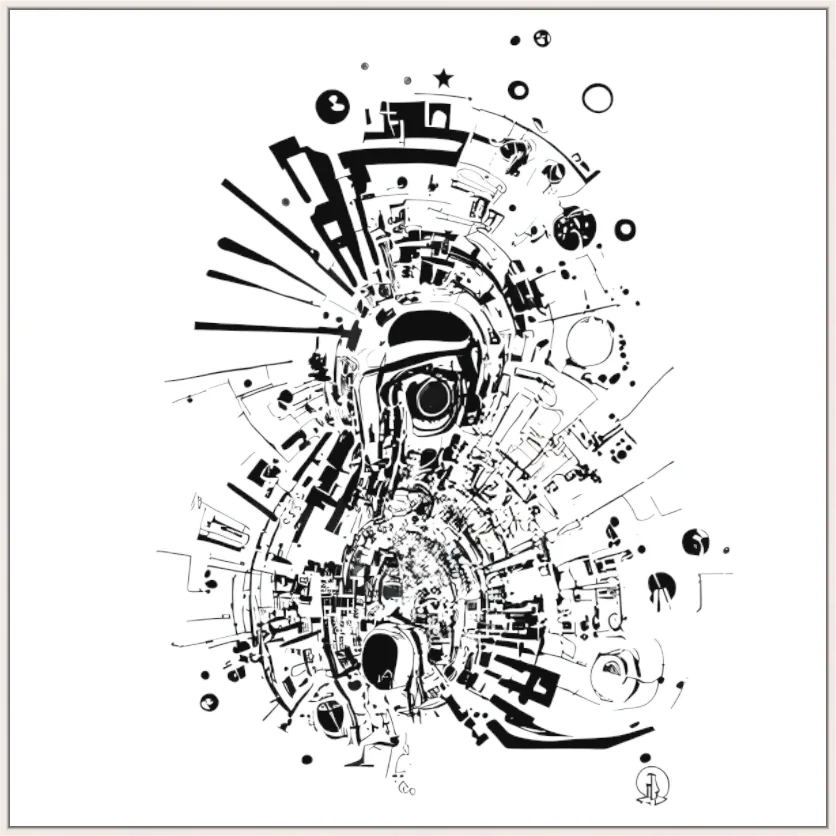
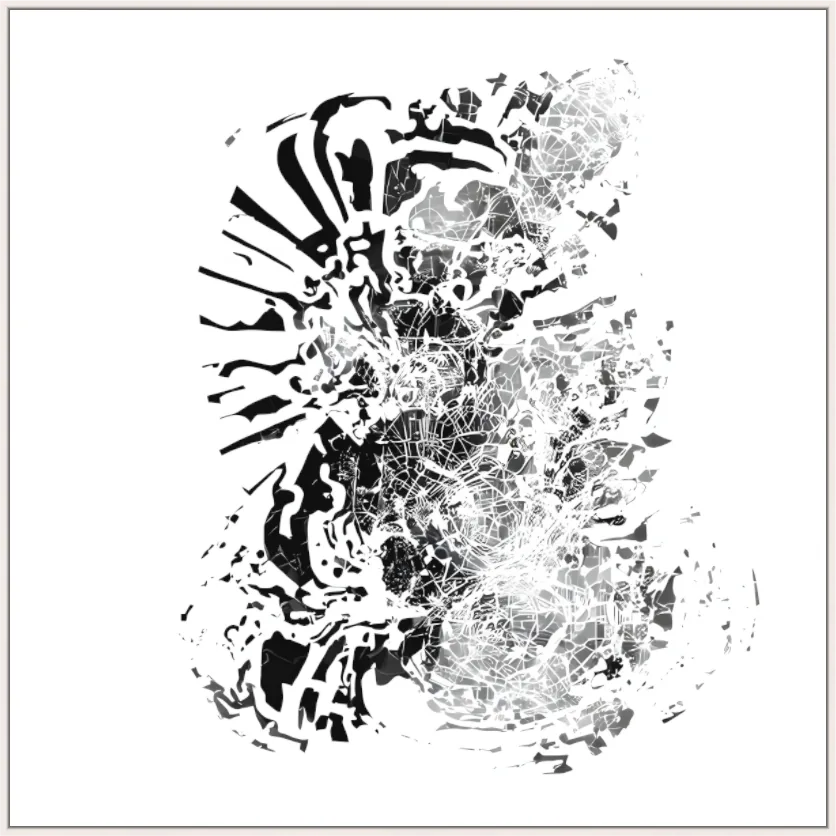
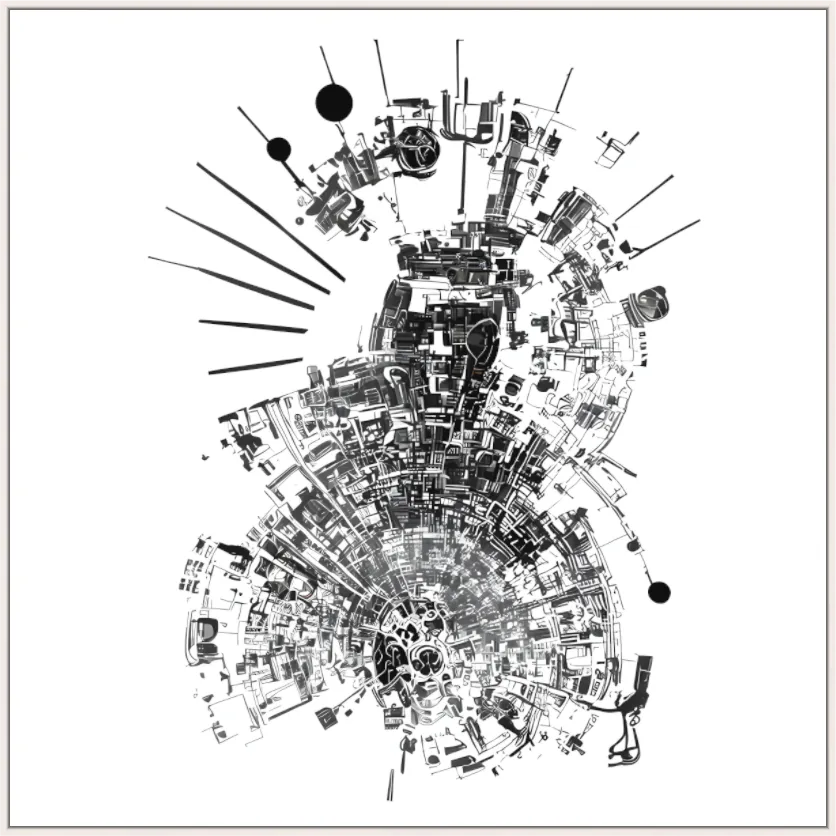
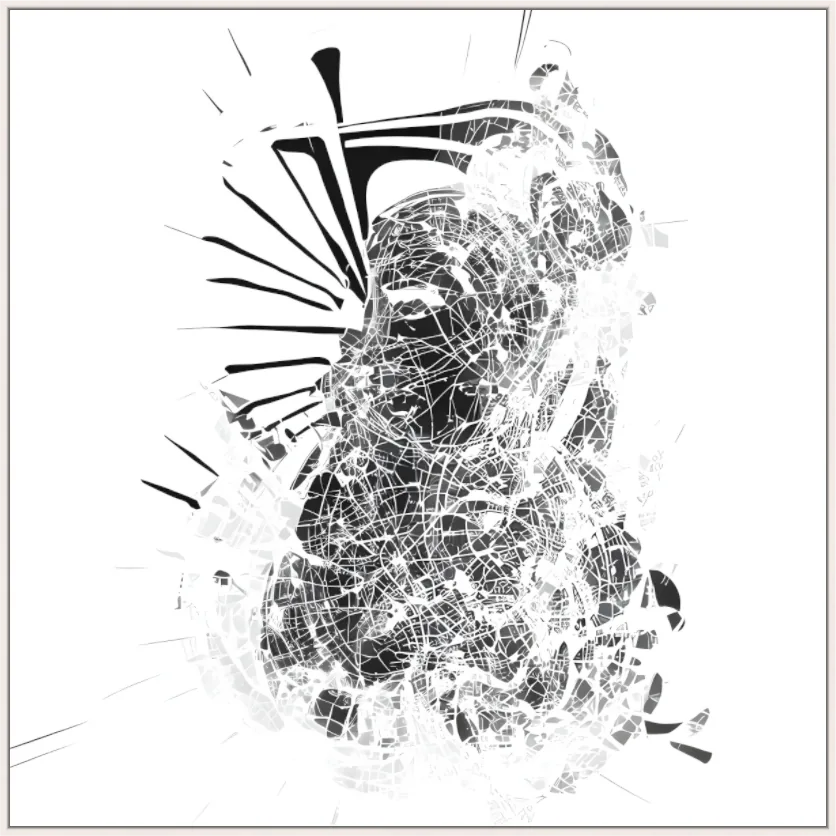
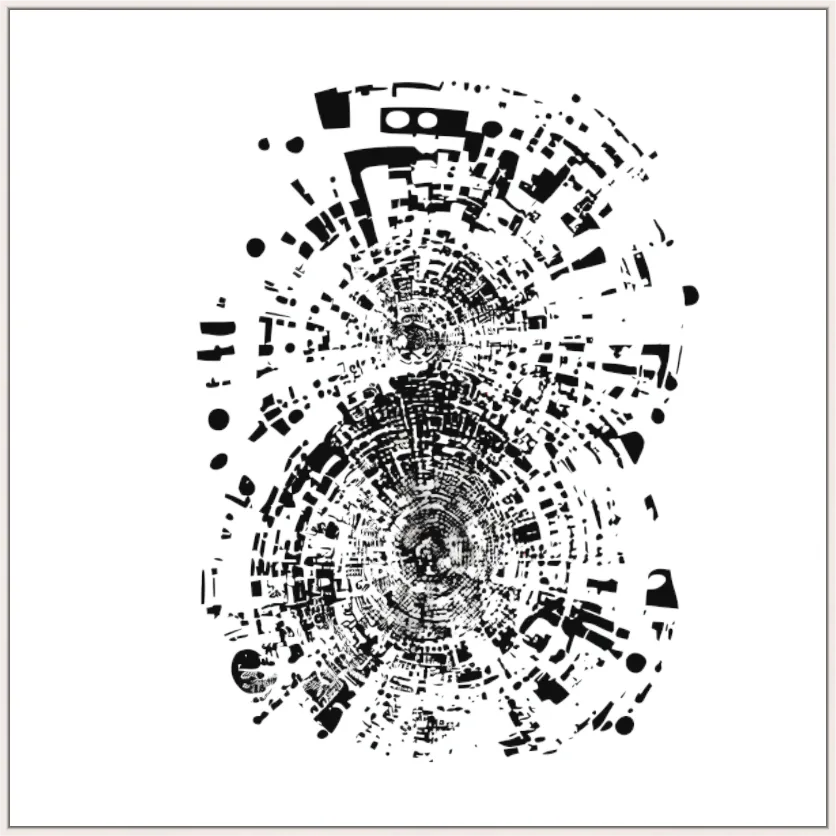
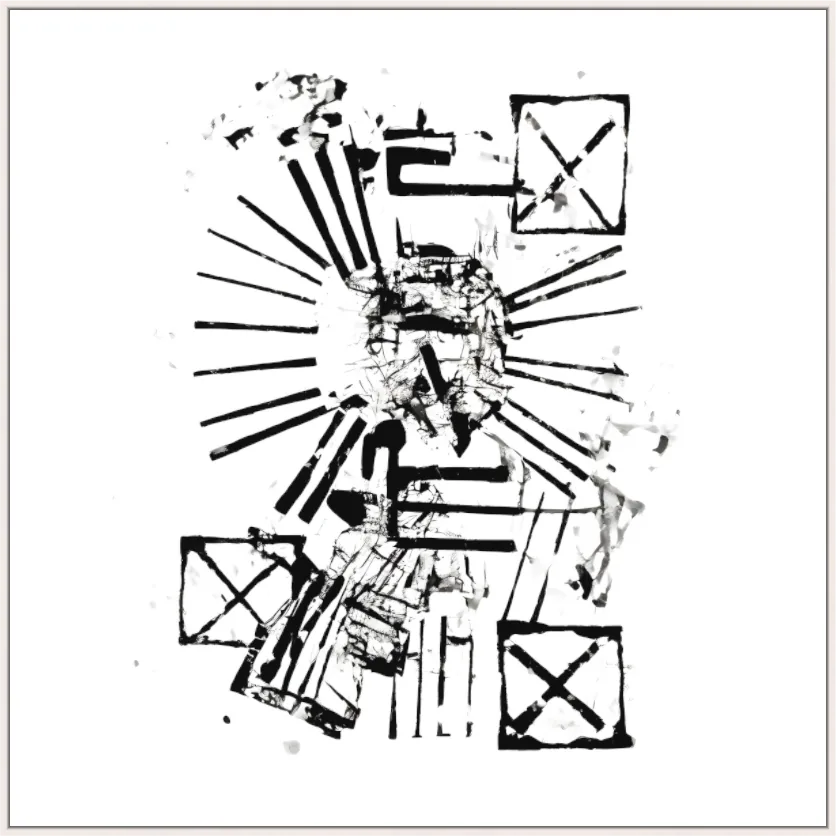
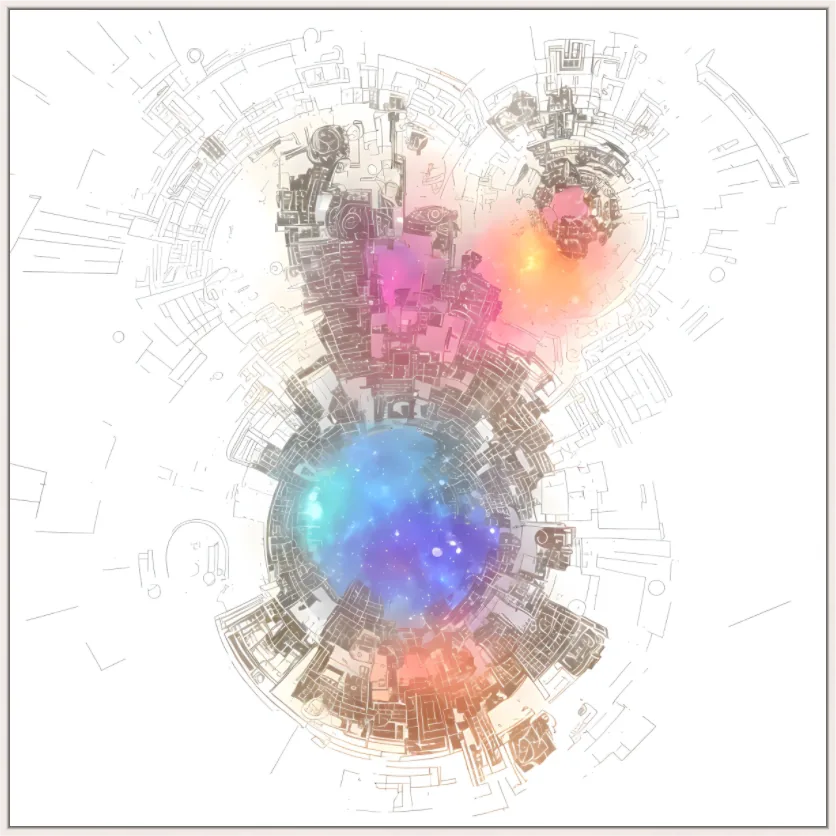
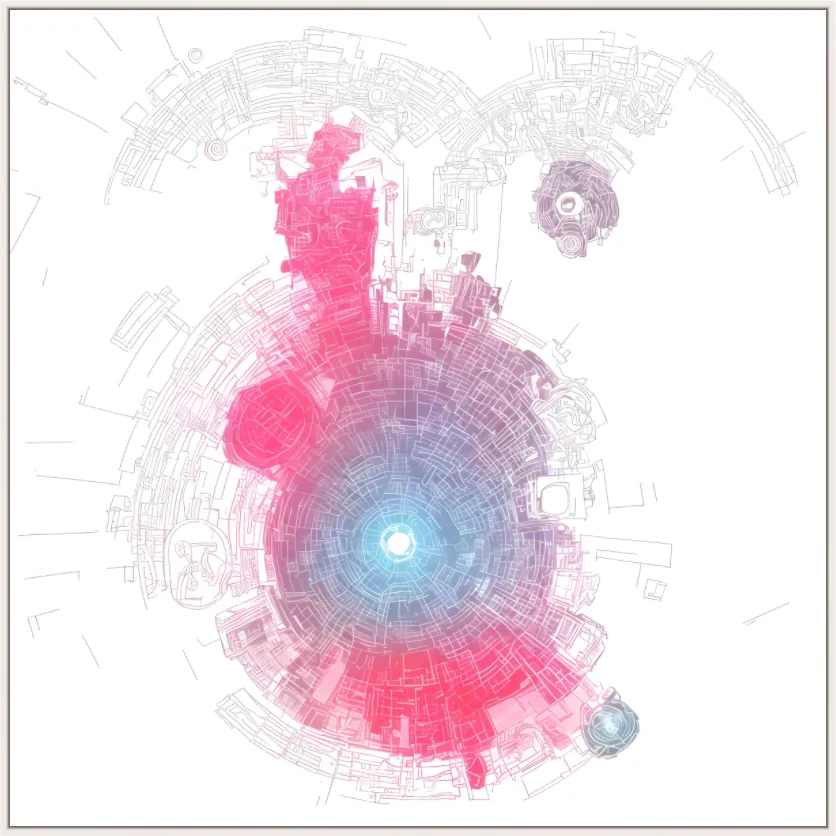
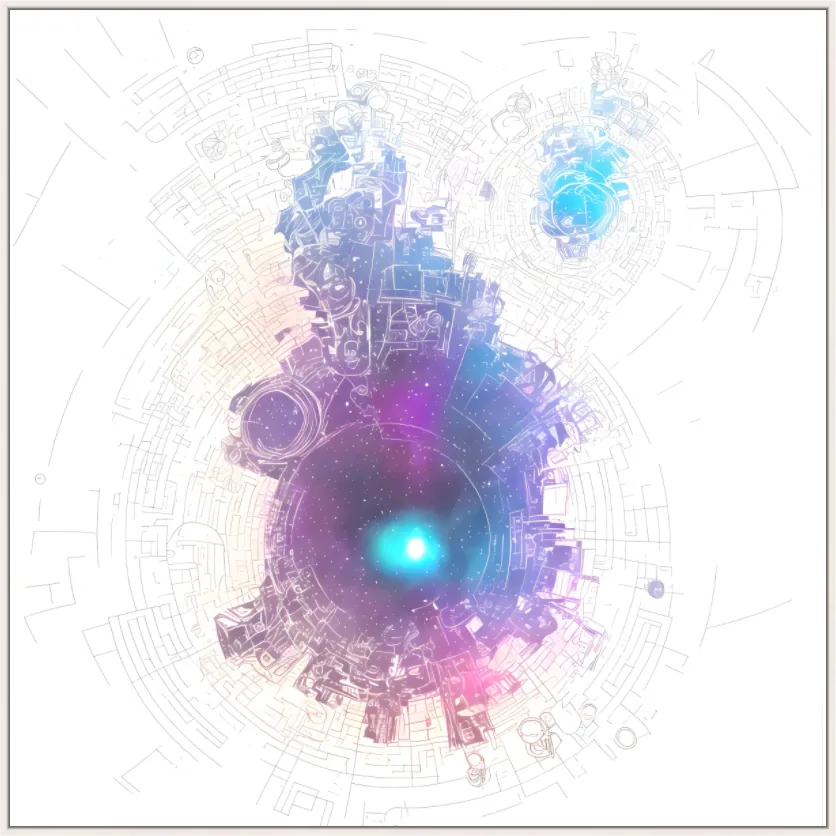
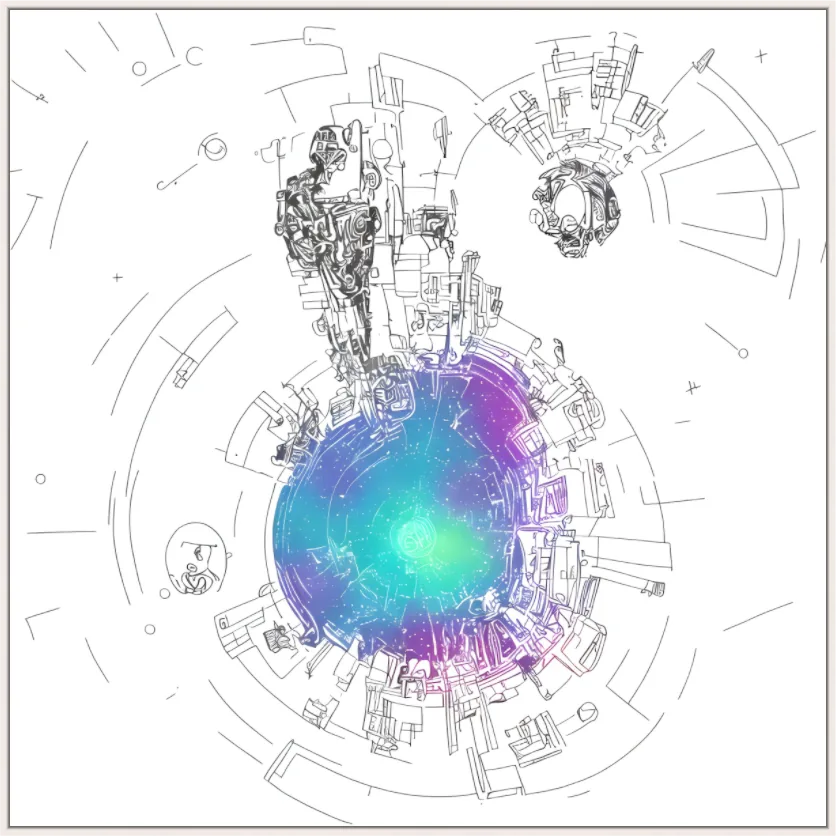
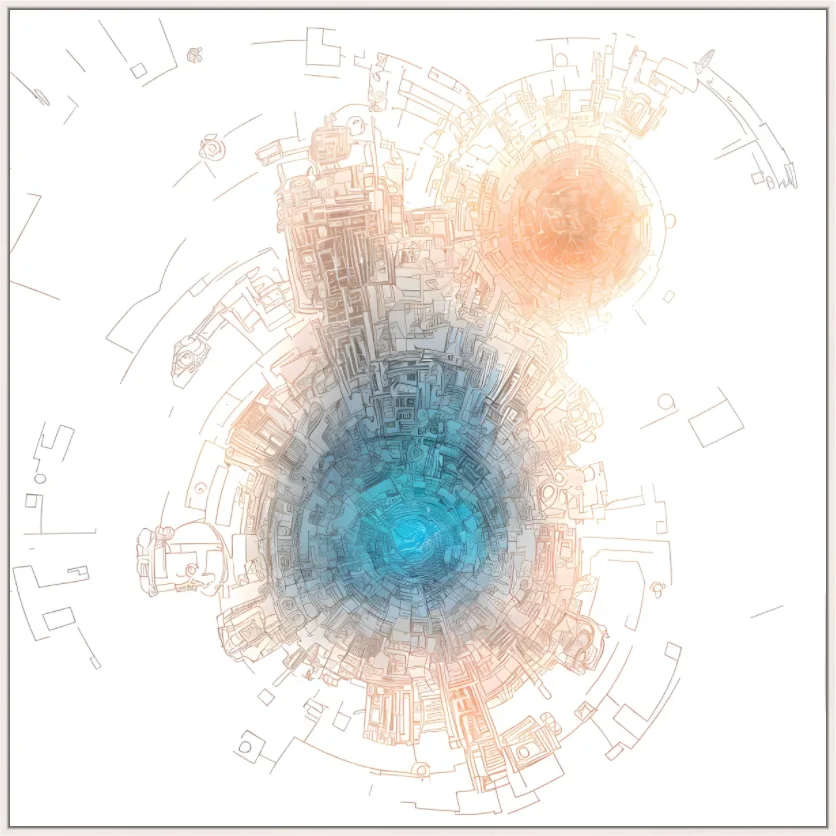
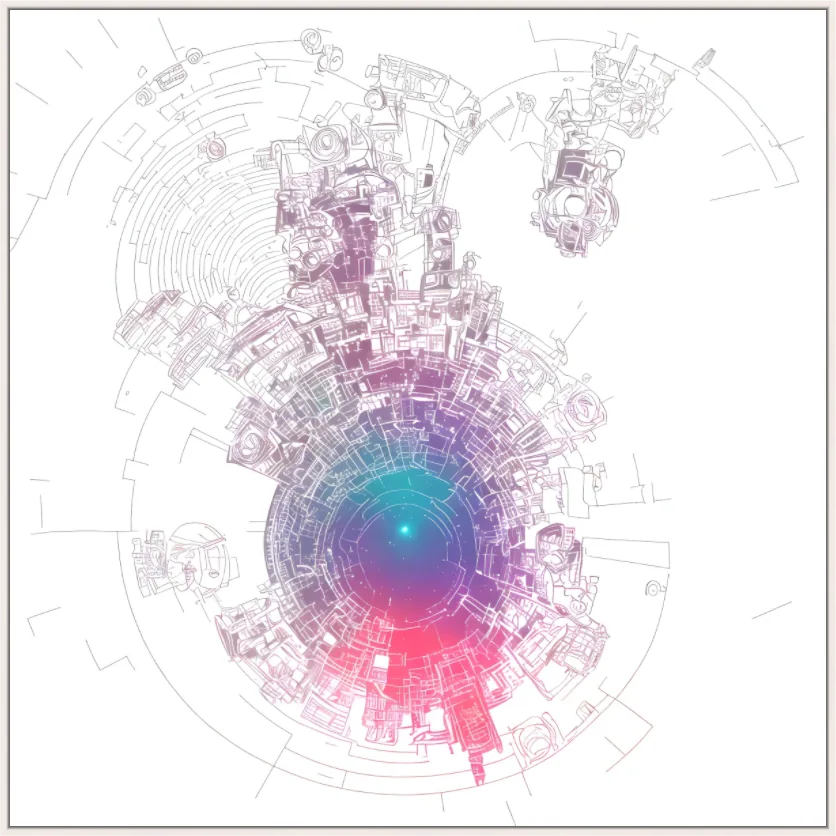
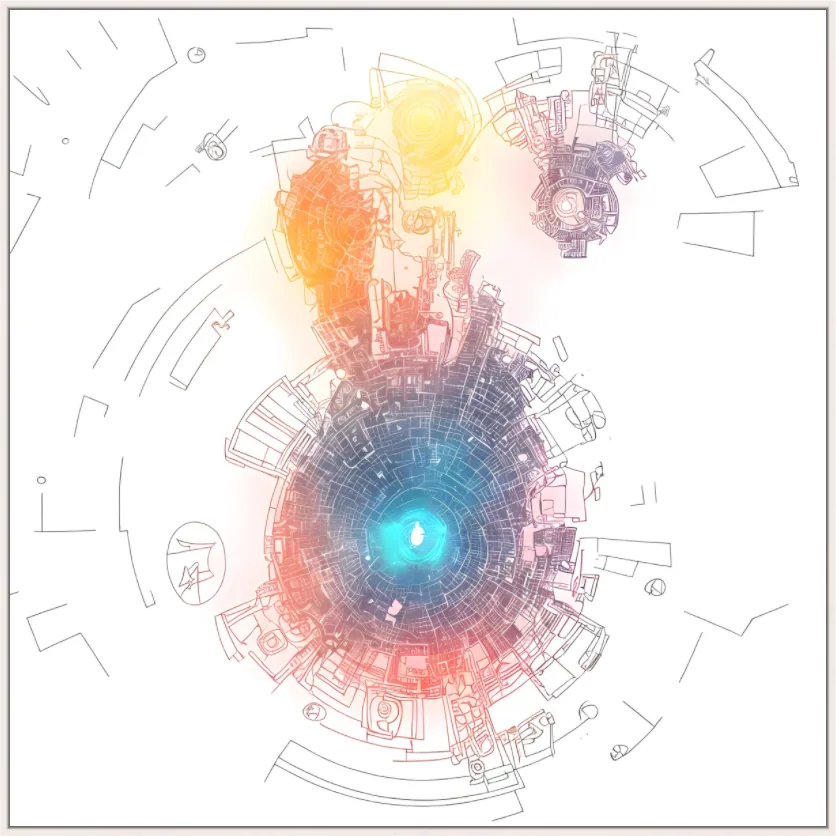
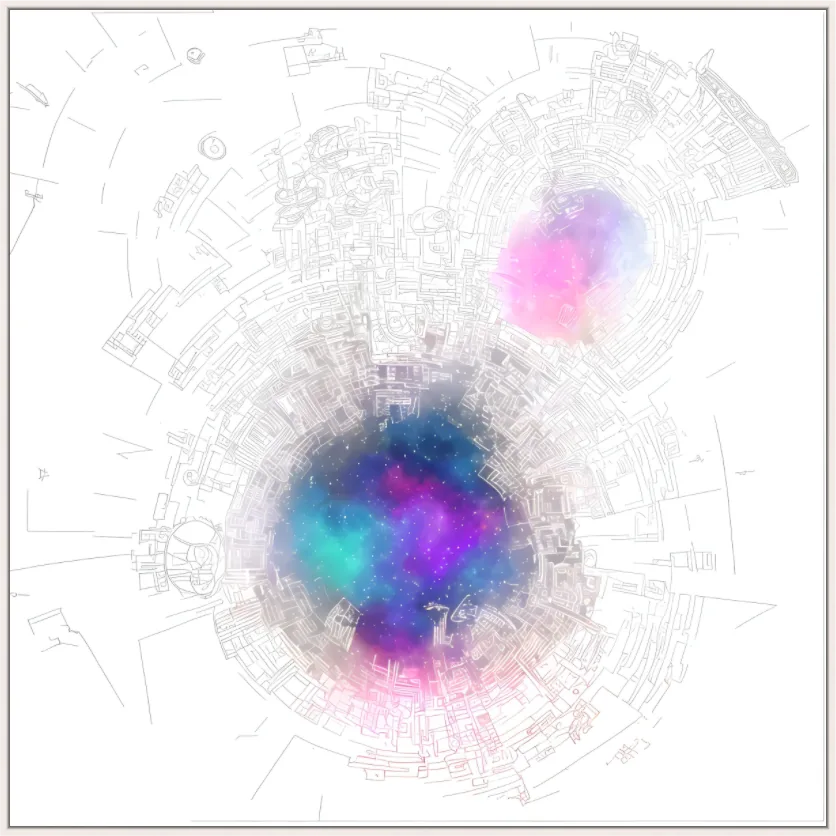
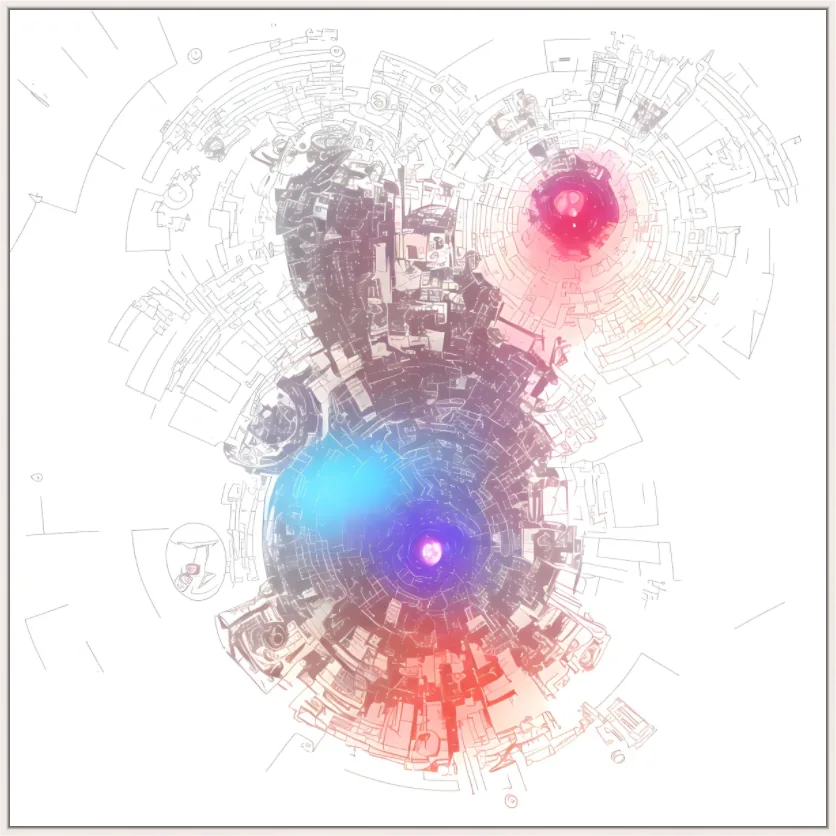
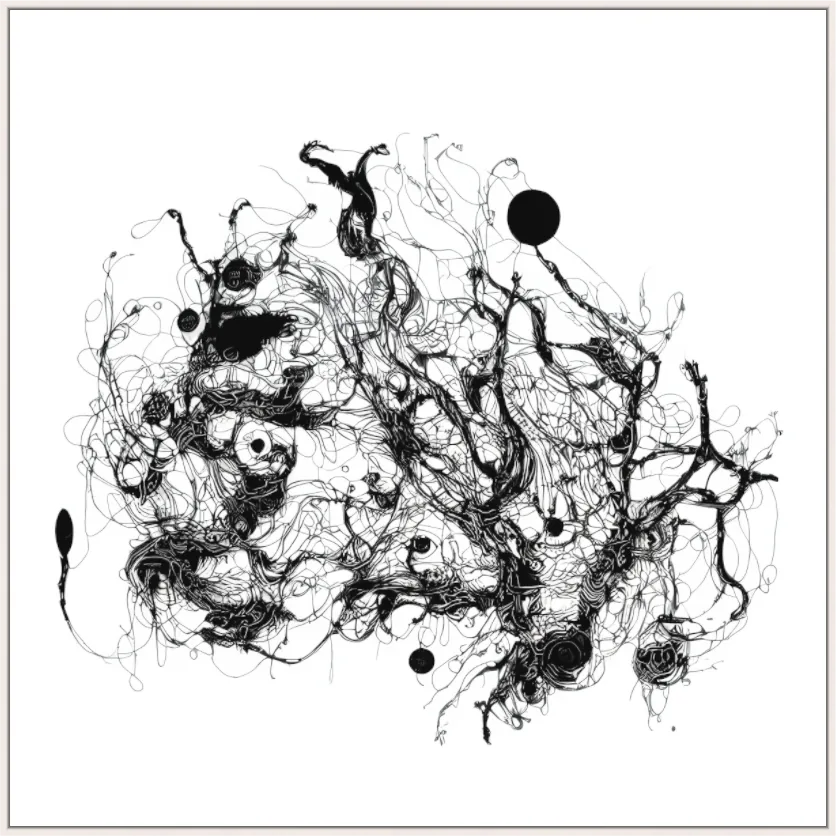
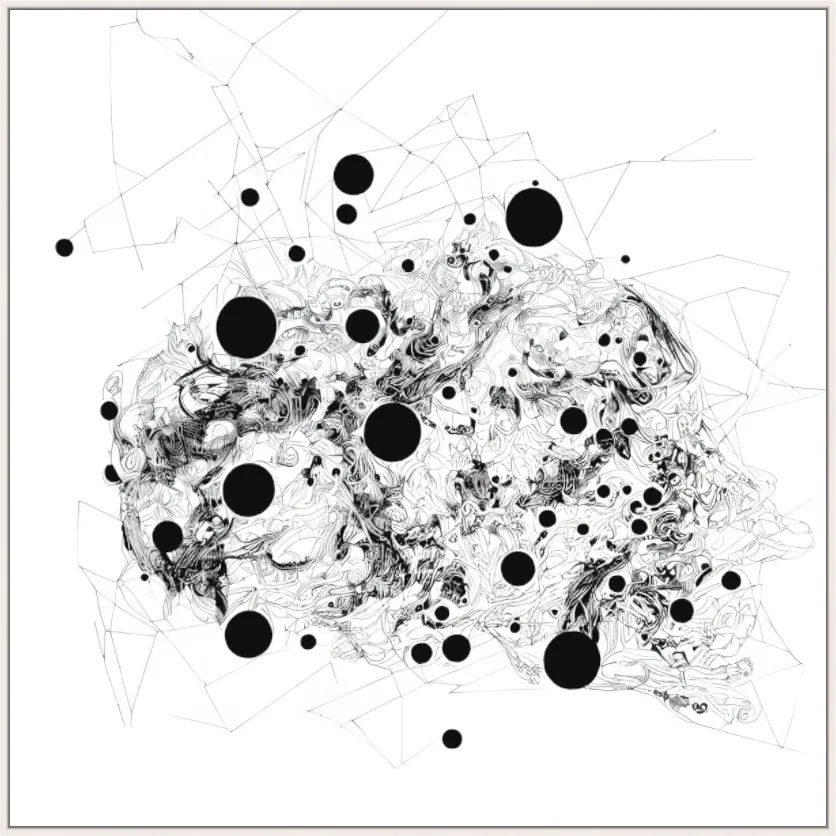
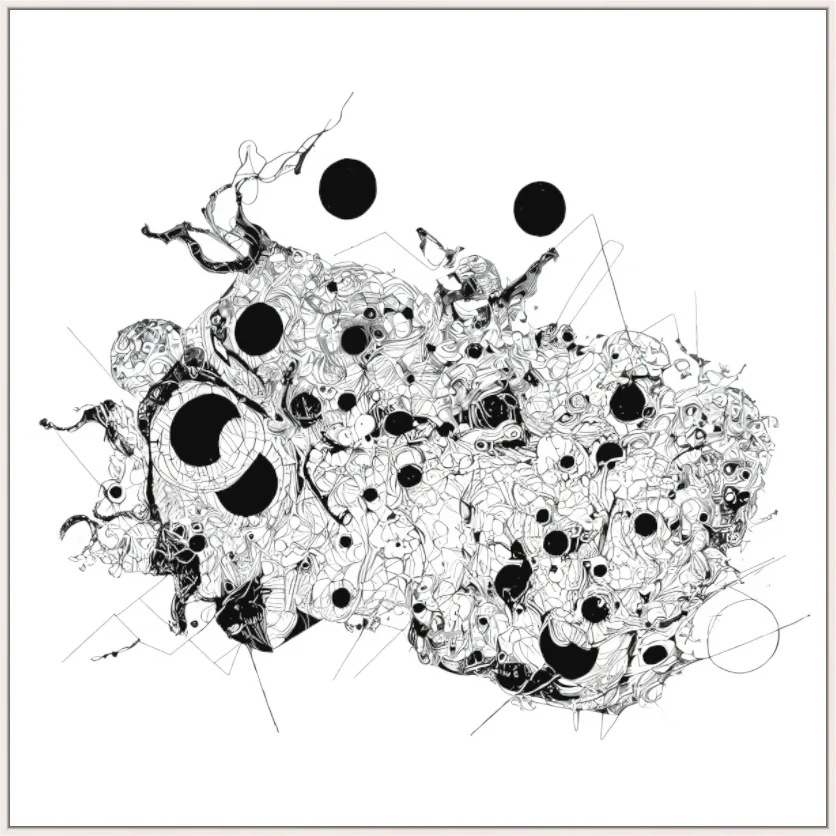
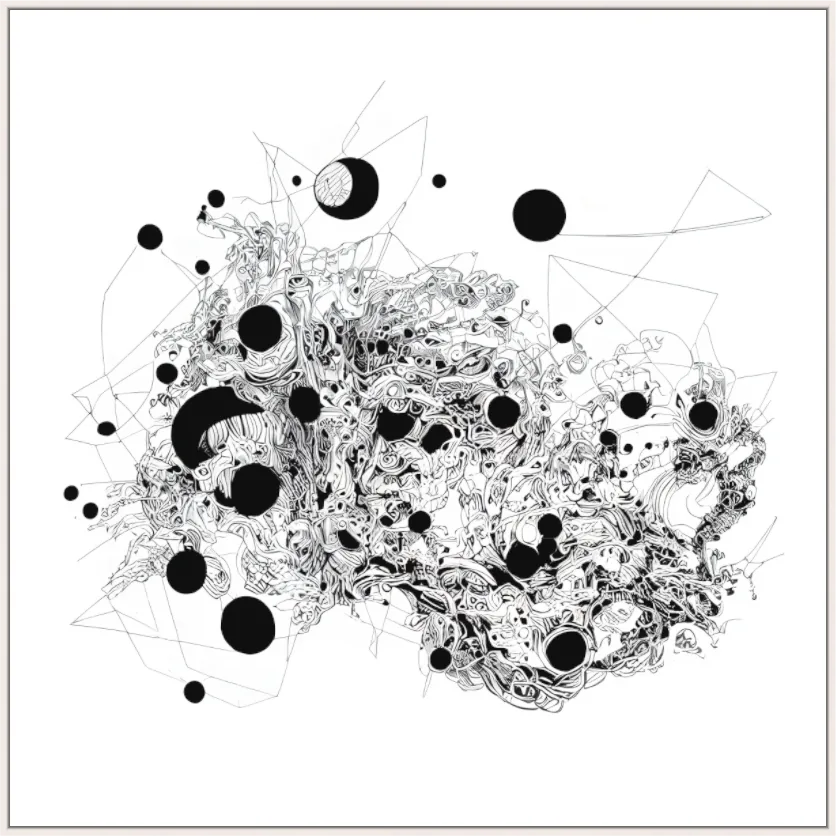
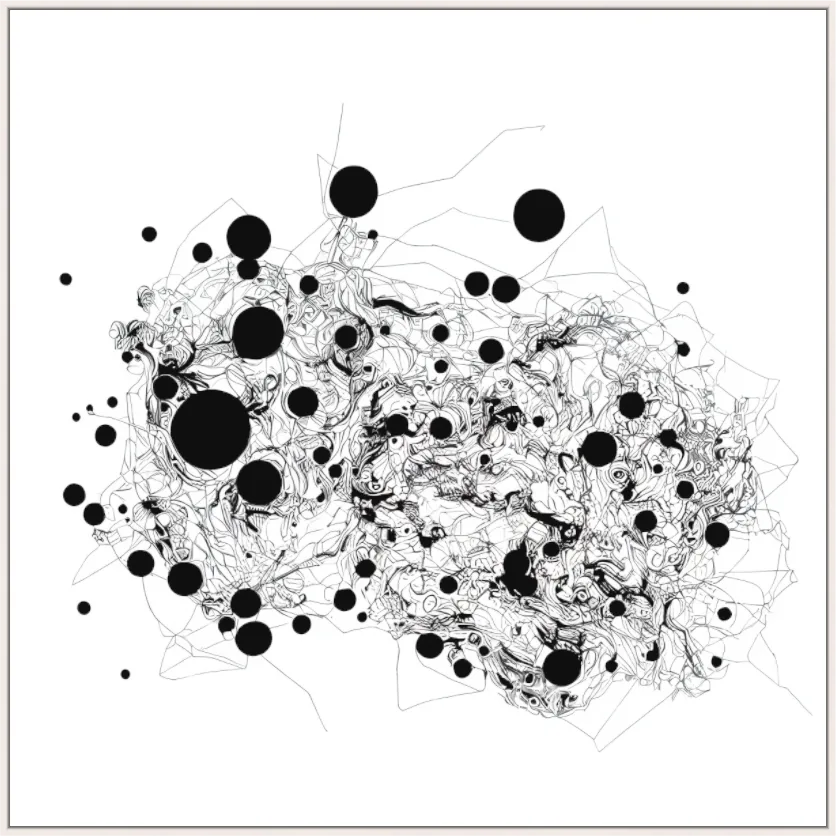
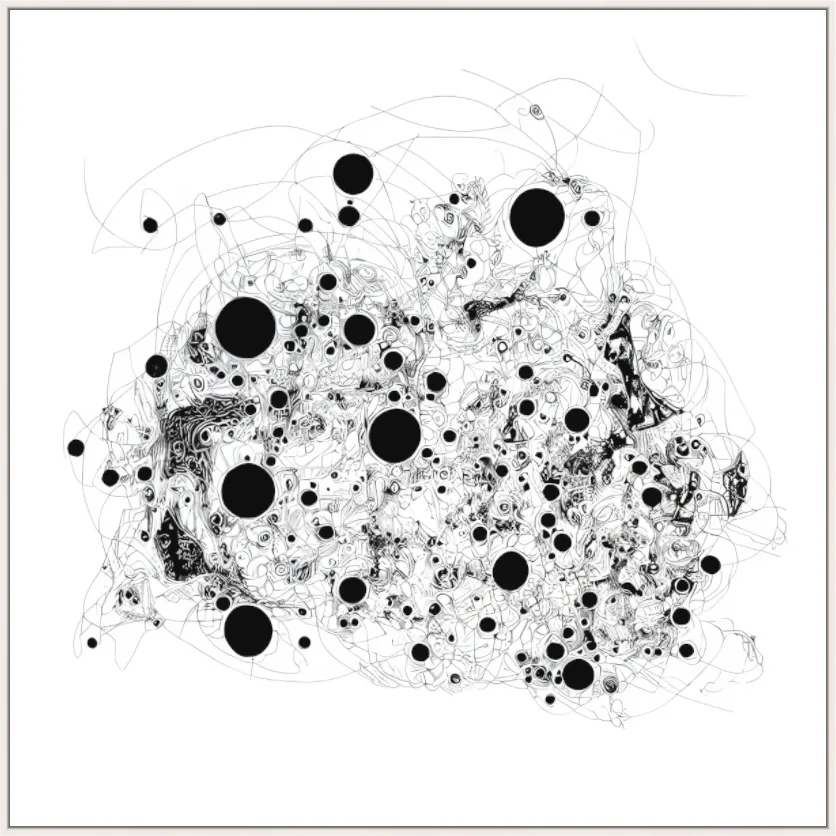
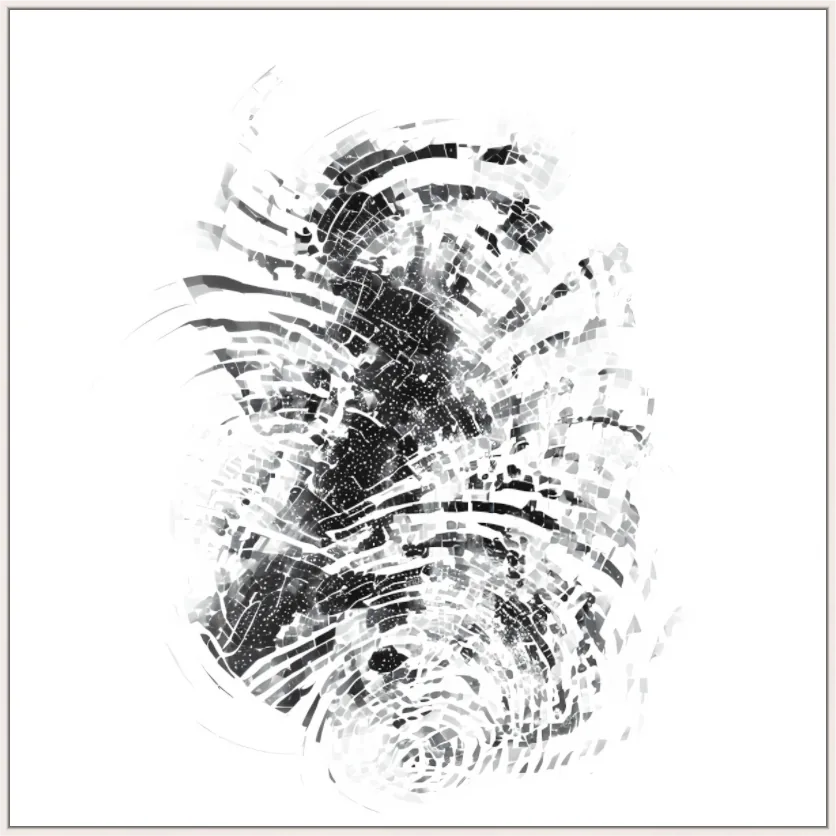
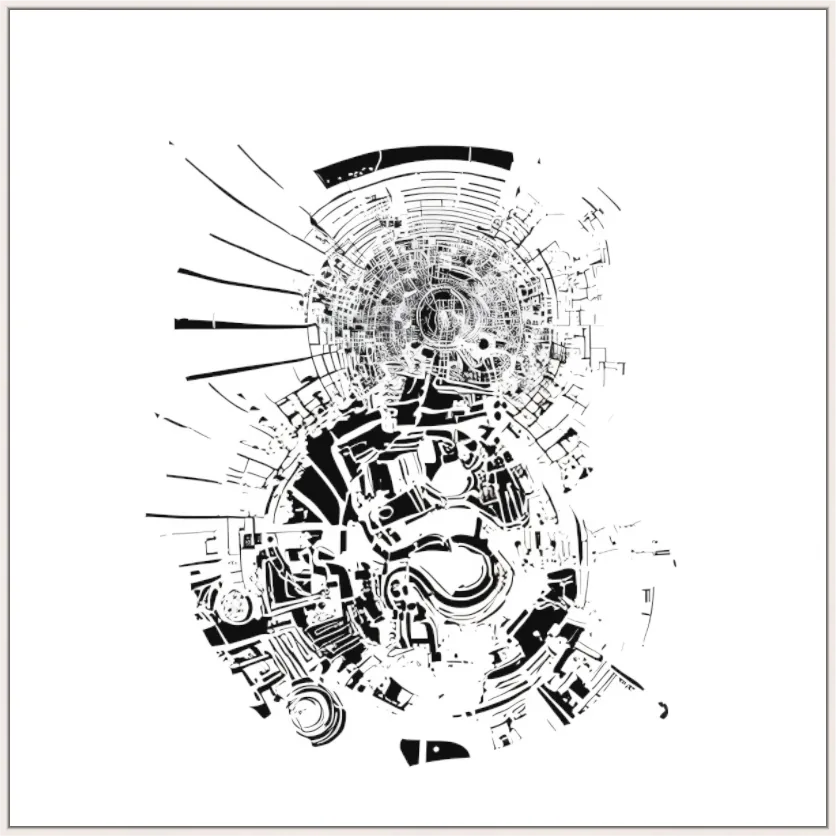
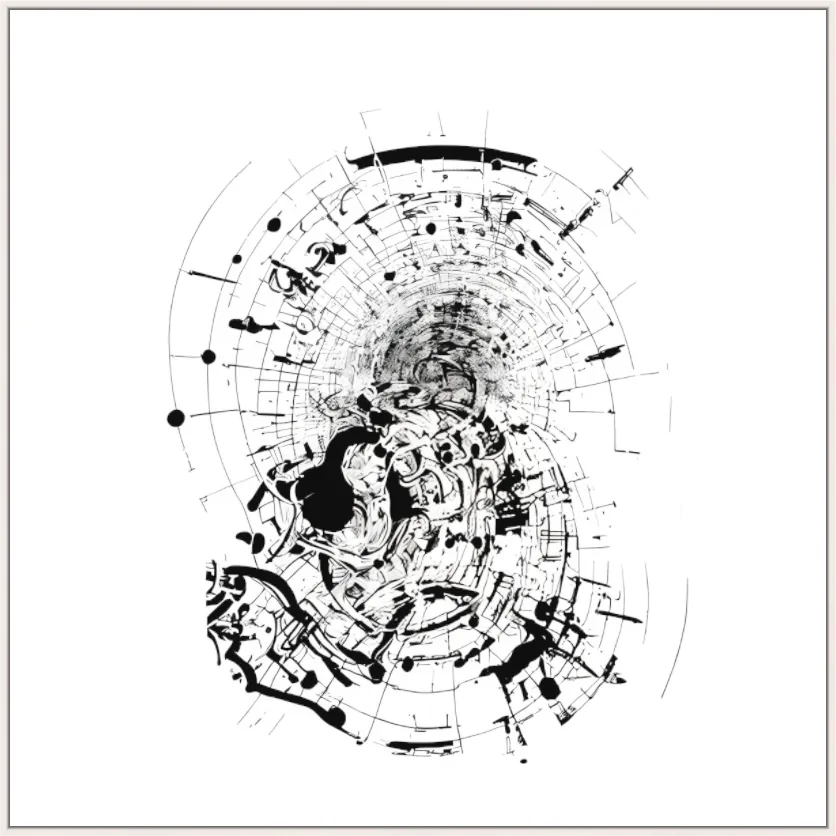
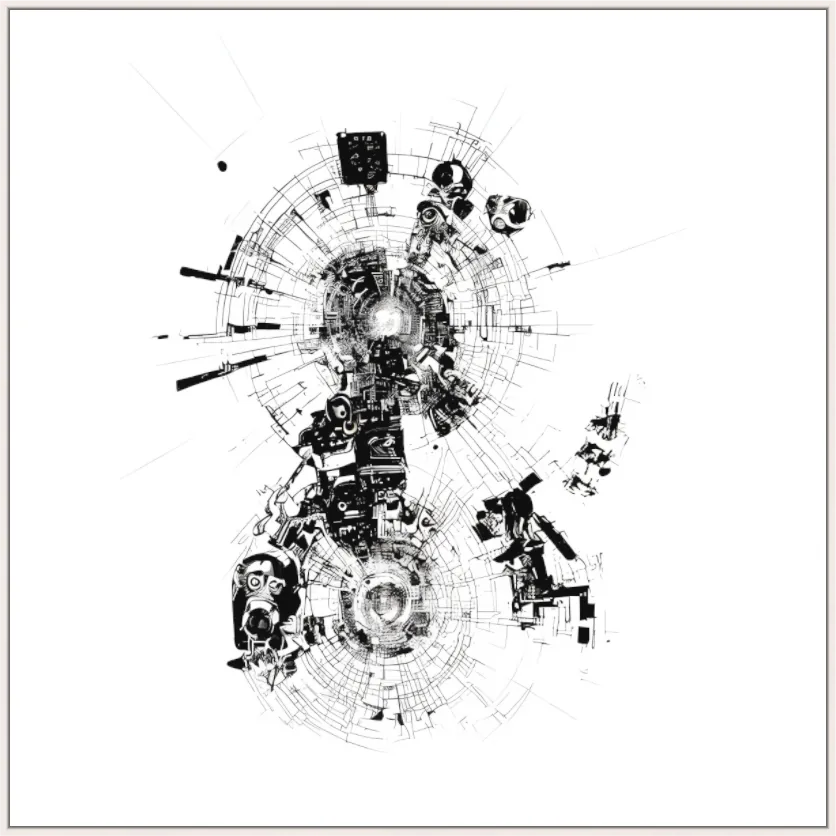
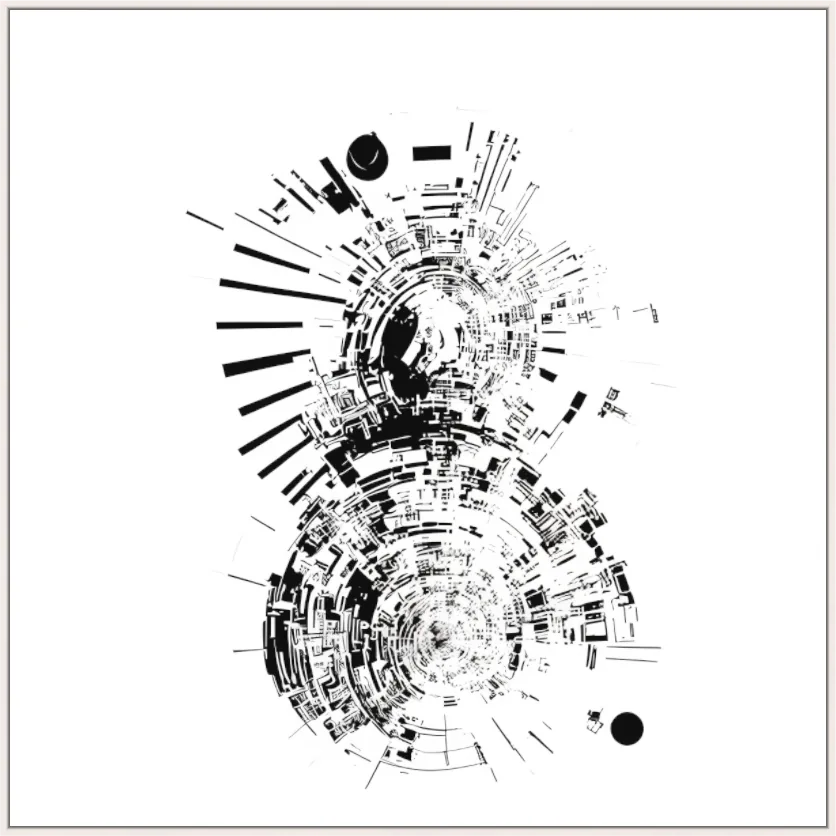
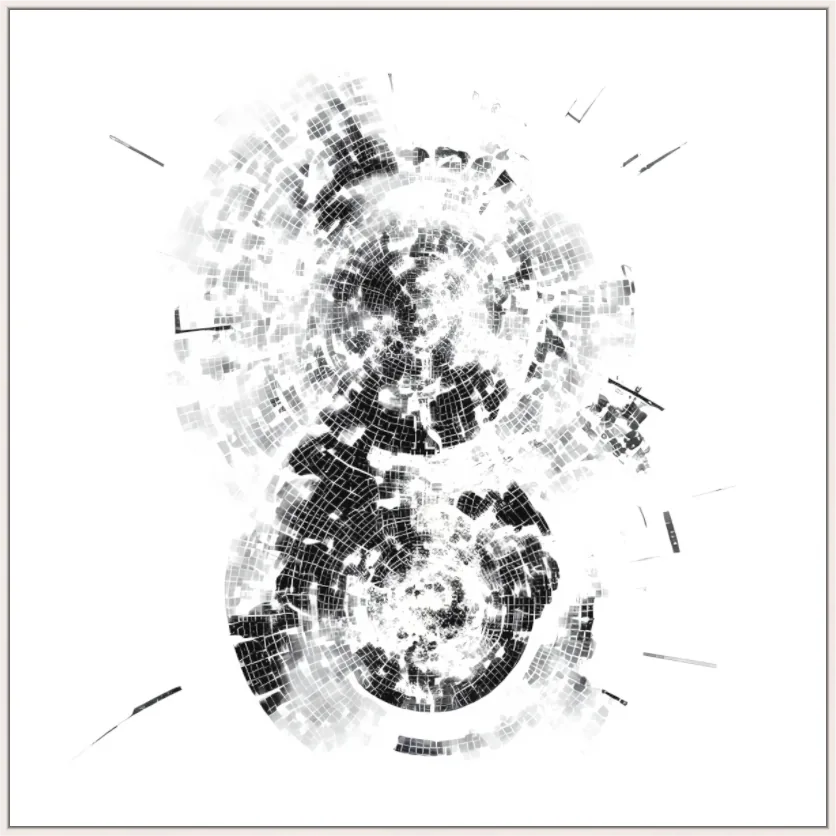
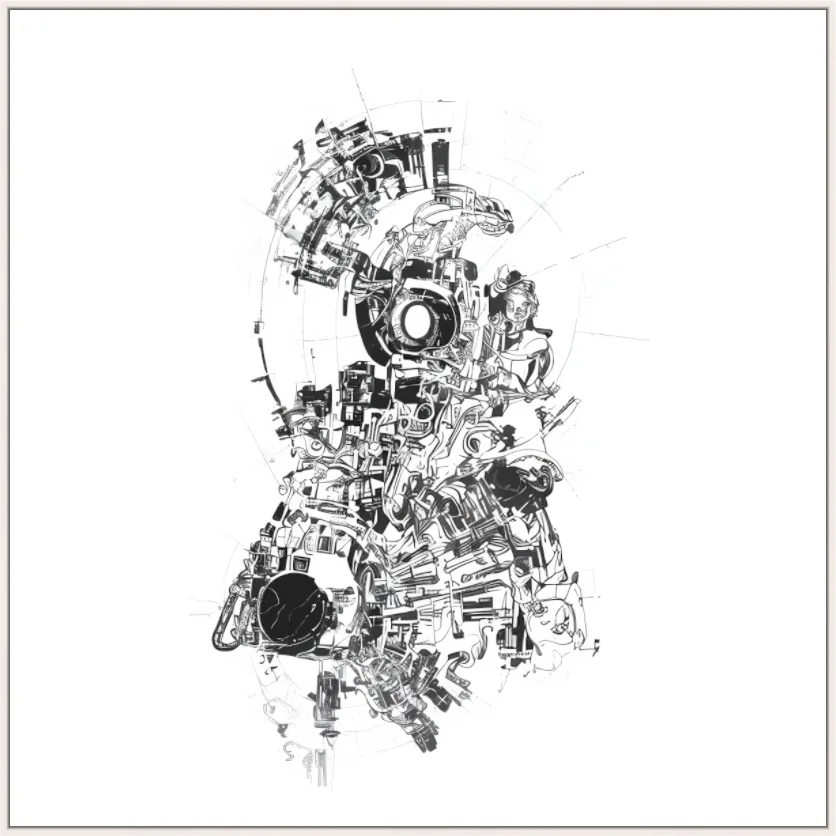
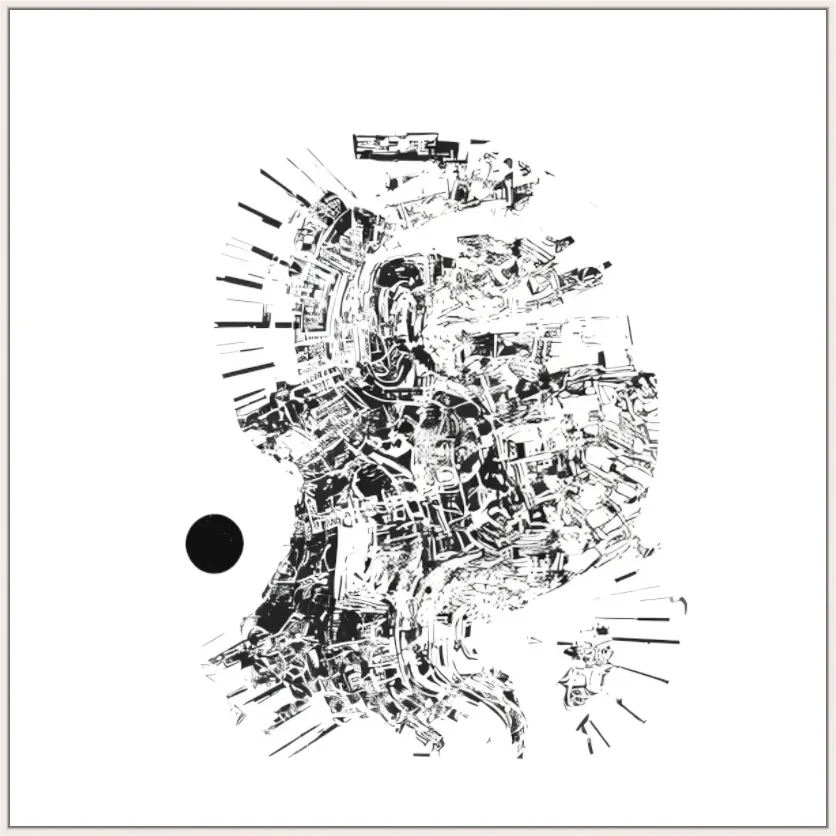
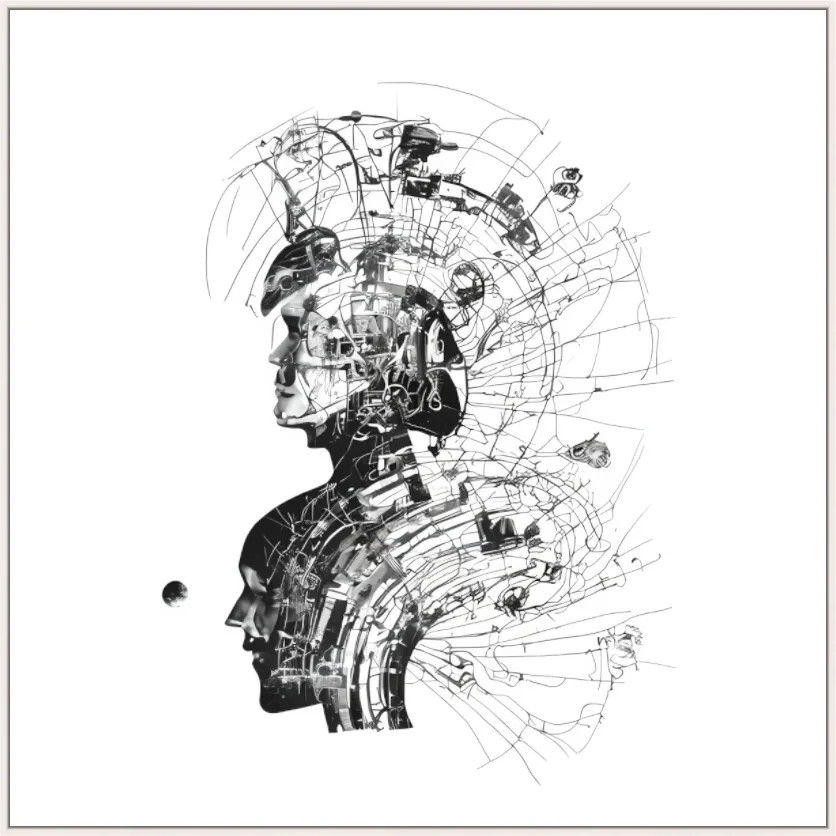
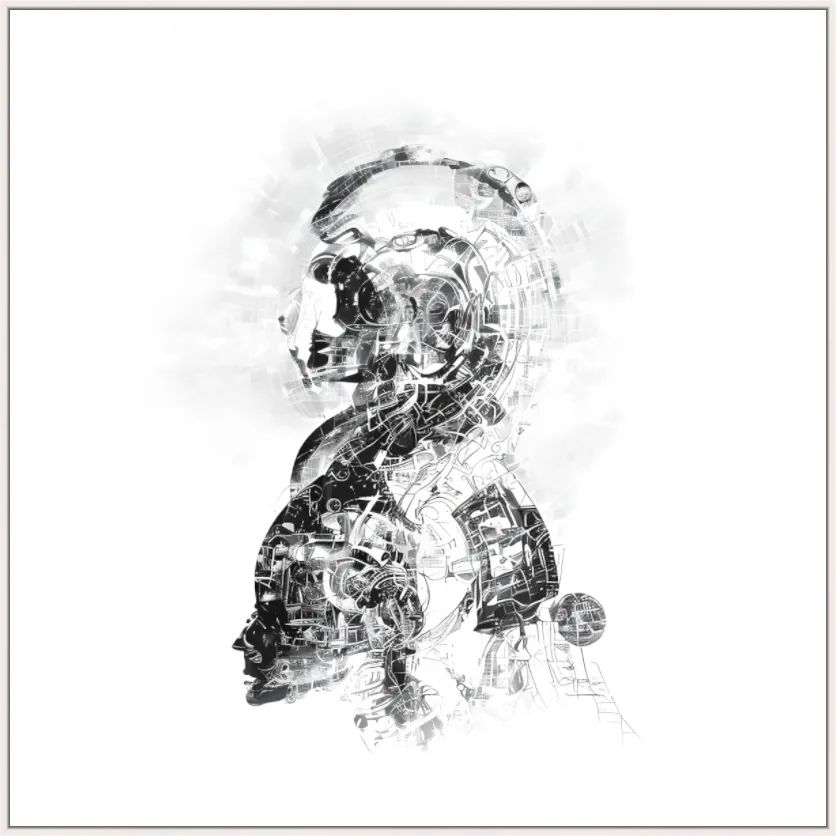
Aus einer Tuscheskizze und einem Prompt aus zwei Wörtern wurden neun Bewegtbildsequenzen. Der Prozess führte durch Generierung, Auswahl, Sortierung nach Ähnlichkeit und Übergänge in After Effects.
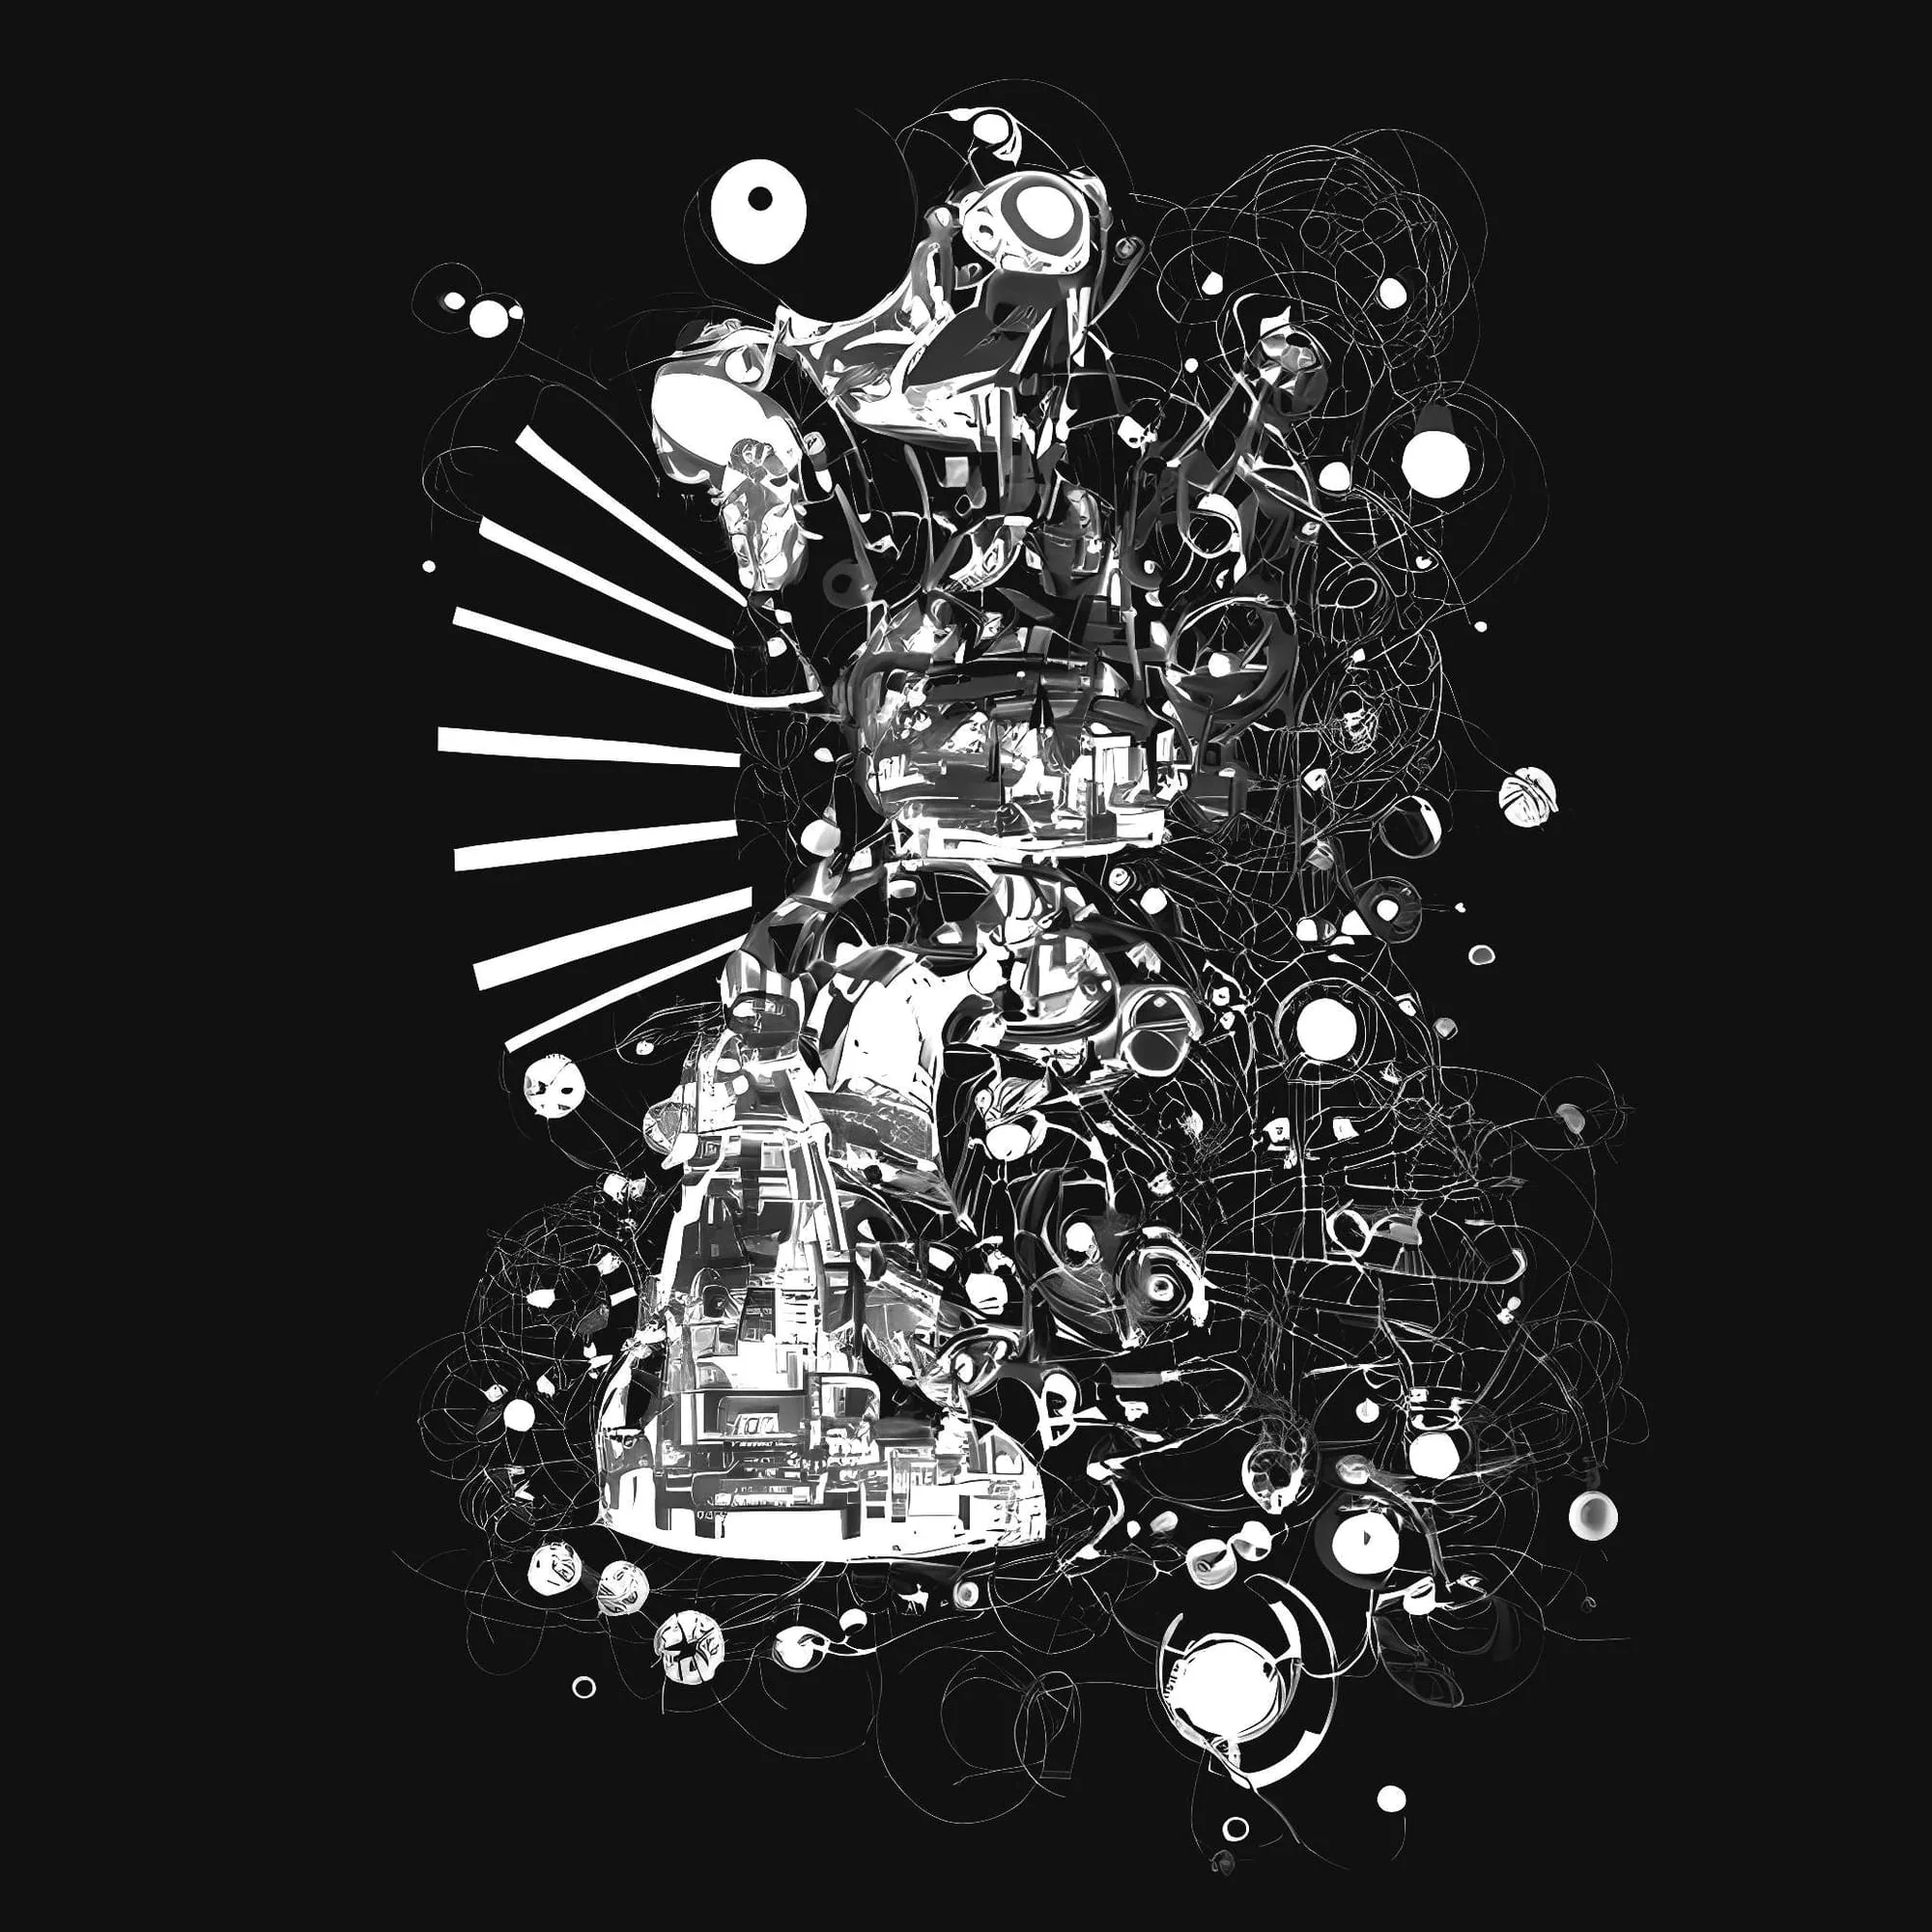
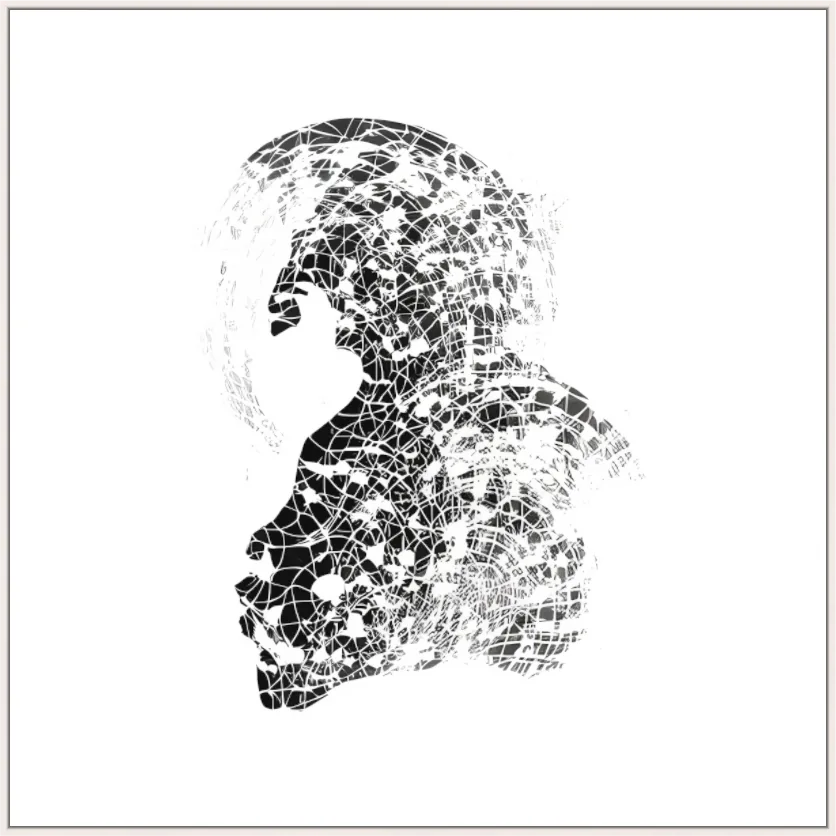
Serie I–IX. Über eine Skizze, einen Prompt und das, was das Modell findet, wenn man aufhört, ihm zu sagen, wonach es suchen soll.
Die Skizze
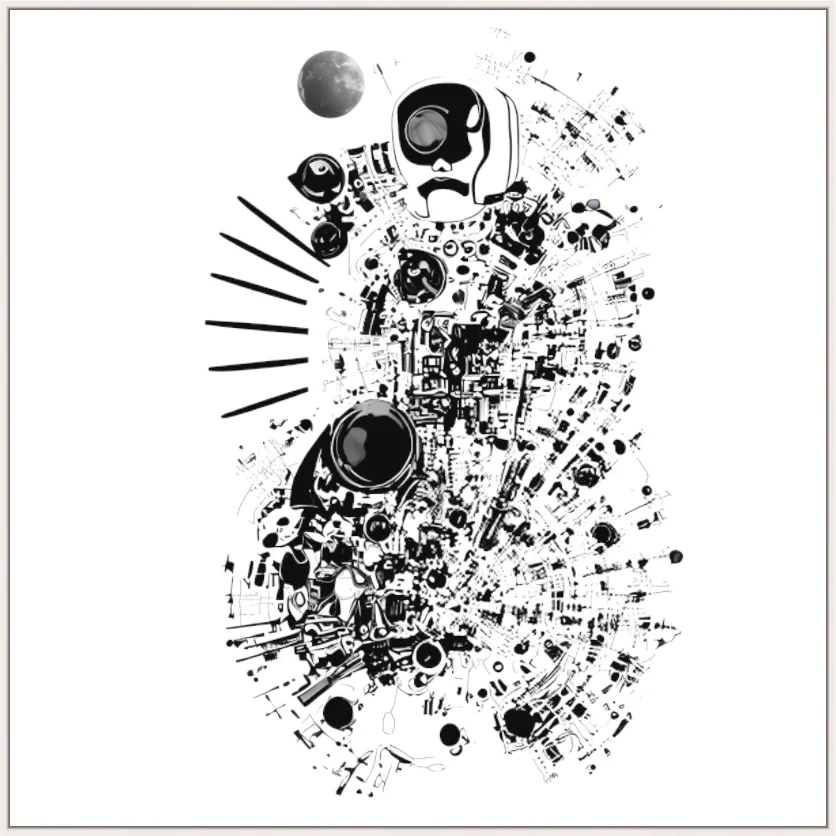
Alles beginnt mit einer handgezeichneten Tuscheskizze – einer einzigen unterbewussten Markierung, in Minuten entstanden, die viel Darstellungsabsicht trägt, beinahe ein Symbol einer Signatur. Allerdings – kein Gesicht, kein Gebäude, keine Landschaft. Ein abstraktes Symbol auf Papier.
Diese Skizze wird zum Keim für alles Folgende. In Stable Diffusion mit ControlNet eingespeist, ist sie die feste Eingabe, die das System über mehrere Wochen in Hunderten von Iterationen interpretiert, neu interpretiert und verwandelt. Der Prompt wird auf zwei Wörter reduziert: intergalactic frequencies. Nichts weiter. Keine Stilanweisungen, keine Motivbeschreibungen, keine kompositorische Anleitung.
Den Prompt auf ein Minimum zu reduzieren war eine Versuchsbedingung: Was tut ein generatives Modell, wenn der Mensch aufhört, ihm zu sagen, was es sehen soll?
Was das Modell fand
Die Antwort war auf zwei Ebenen unerwartet.
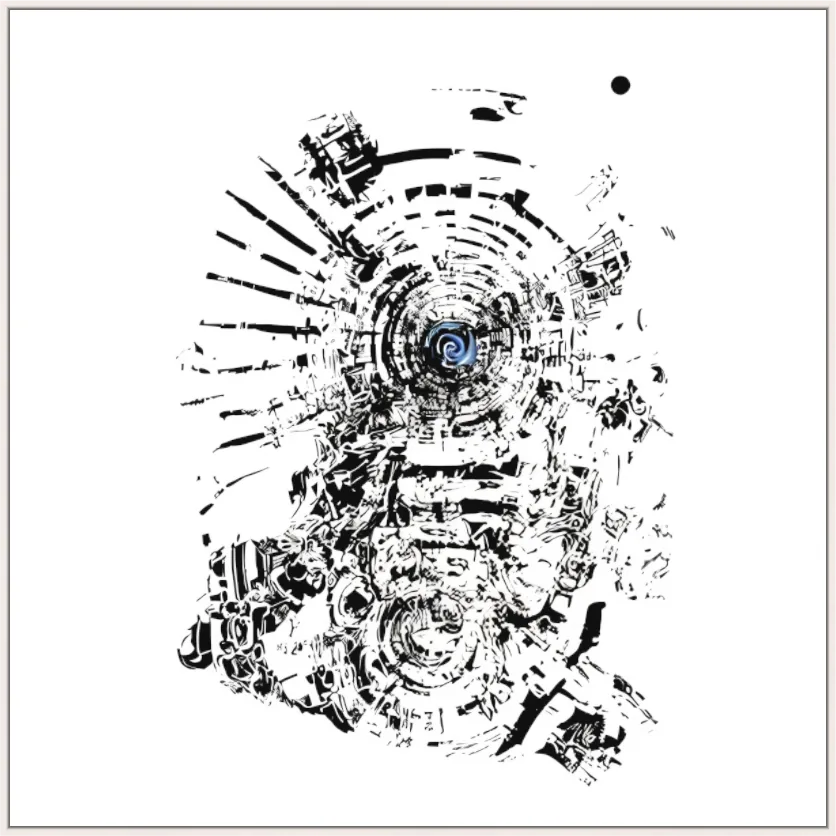
Erstens: Je unspezifischer der Prompt, desto vielfältiger und strukturell überraschender wurden die Ausgaben. Durchläufe mit hoher Guidance und detaillierten Prompts erzeugten vorhersehbare Ergebnisse – kompetent, kohärent, tot. Durchläufe mit niedriger Guidance und dem Zweiwort-Prompt erzeugten Bilder, um die niemand gebeten hatte: emergente Symmetrien, räumliche Strukturen, die architektonisch wirkten, ohne Gebäude zu sein, Texturen, die zwischen organisch und kristallin oszillierten.
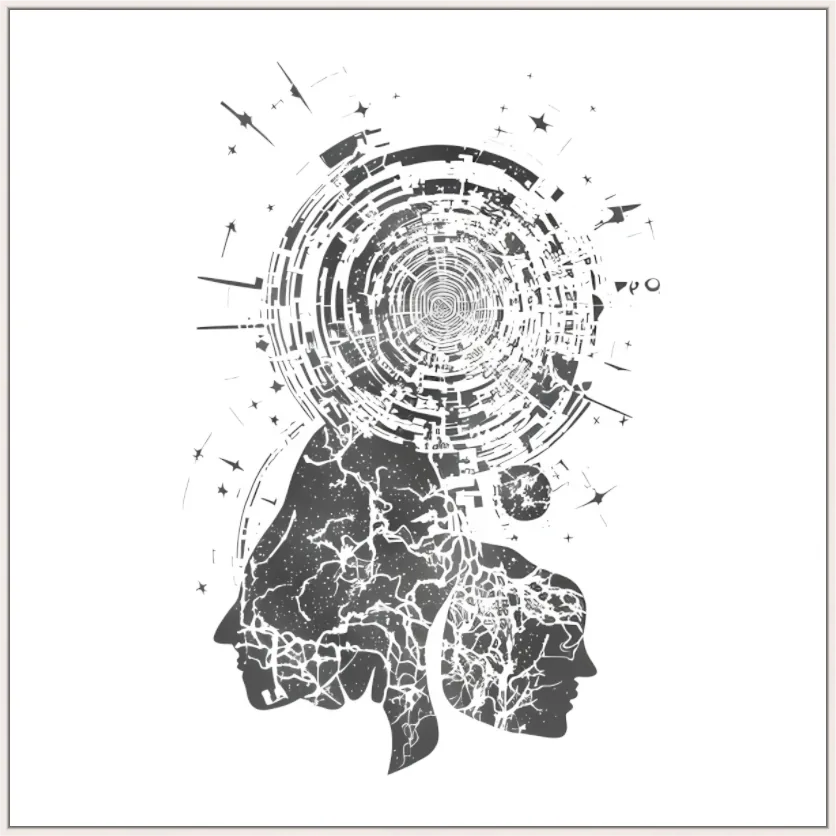
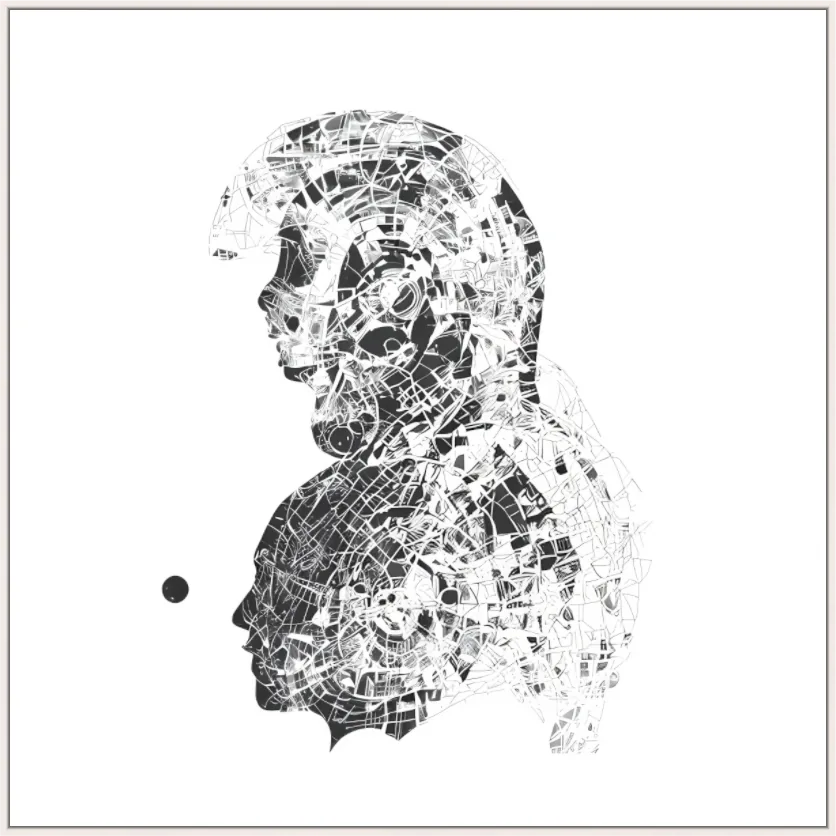
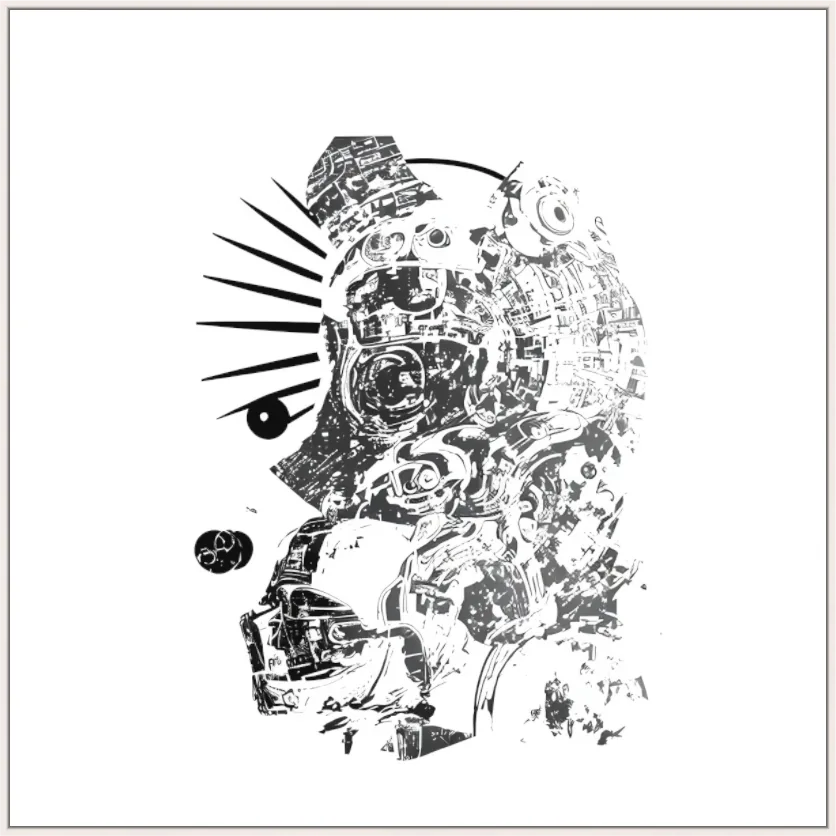
Zweitens, und interessanter: Das Modell führte durchgehend Gesichter ein. Kein Gesicht war vorgegeben. In der Eingabeskizze gab es keine Gesichtsreferenz. Doch über die Iterationen hinweg erschienen Gesichtsstrukturen – fragmentiert, verwandelt, manchmal kaum erkennbar, aber beharrlich. Das Netzwerk, trainiert auf Millionen von Bildern, in denen Gesichter statistisch dominieren, tendiert zur menschlichen Form, selbst wenn nichts in der Eingabe danach verlangt. Sichtbar gewordener Bias – die Trainingsdaten, die sich durch die Abwesenheit von Anweisungen ausdrücken.
Die frühen Durchläufe verwendeten erweiterte Prompts – Myzelstrukturen, Fluchtpunkte, Bewusstsein, Octane Render, Yoshitaka Amano – mit hohen Guidance-Skalen. Die Ergebnisse waren illustrativ und kontrolliert. Das Projekt wurde erst interessant, als dieses Gerüst entfernt wurde. Zwei Wörter. Niedrige Guidance. Die Skizze als Anker.
Ein detaillierter Prompt sagt dem Modell, was es produzieren soll. Ein minimaler Prompt fragt das Modell, was es findet. Der Mensch liefert die Einschränkung, das Netzwerk die Interpolation.
Der Prozess
Die technische Pipeline hat vier Stufen, von denen jede eine eigene Funktion erfüllt:
Generierung. Die Tuscheskizze wird mit Stable Diffusion v1.5 durch ControlNet (Canny, OpenPose, Depth und andere) verarbeitet. Die Parameter werden über die Durchläufe hinweg angepasst – Inferenzschritte zwischen 60 und 100, Guidance-Skala zwischen 5 und 15, mehrere Sampler werden getestet. Generierte Bilder werden als Eingaben für nachfolgende Iterationen zurückgeführt, wodurch eine Rückkopplungsschleife entsteht, in der jede Generation auf der letzten aufbaut.
Auswahl. Aus Hunderten generierter Bilder wird eine Teilmenge gewählt – nicht nach technischer Qualität (viele technisch saubere Bilder werden verworfen), sondern danach, ob das Bild etwas trägt, das der Künstler nicht hineingelegt hat und dennoch als bedeutsam erkennt. Dieser Schritt lässt sich nicht automatisieren. Es ist somatisches Urteilen: das gefühlte Empfinden unterhalb der Artikulationsschwelle, dass dieses eine zählt.
Sortierung. Die ausgewählten Bilder werden mit ResNet50 (TensorFlow) verarbeitet, um Ähnlichkeitsbeziehungen zwischen Einzelbildern herzustellen. Ein alternativer Ansatz – Bilder zu kacheln und Regionen nach Merkmalsähnlichkeit zu clustern – wurde getestet und verworfen; er zersplitterte die Sequenzen und zerstörte die Kontinuität. Die ganzheitliche Sortierung mit ResNet50 bewahrte den visuellen Bogen.
Morphing. Adobe AfterEffects überbrückt mit Time-Warping-Techniken die Lücken zwischen Einzelbildern und erzeugt die Illusion kontinuierlicher Bewegung. Die Grenzen sind sichtbar – einige Bilder werden übersprungen, einige Übergänge stocken. Eine nächste Stufe, derzeit in Entwicklung, umfasst das Training eines eigenen Interpolationsnetzwerks, das Zwischenbilder generiert und so flüssigere Übergänge innerhalb der sich entwickelnden visuellen Logik erreicht.
Das Ergebnis sind neun kurze Sequenzen, veröffentlicht als experimentelle Videoarbeiten.
Was die Unvollkommenheiten tragen
Der Diskurs über generative KI wird vom Streben nach Fotorealismus beherrscht – bessere Gesichter, bessere Hände, weniger Artefakte. Der gesamte Bewertungsrahmen setzt voraus, dass die Aufgabe des Modells darin besteht, Wirklichkeit zu simulieren, und dass Abweichungen von der Simulation Fehler sind.
Intergalactic Frequencies vertritt die entgegengesetzte Position. Die verzerrten Hände, die verwandelten Gesichter, die nichtmenschlichen Züge, die räumlichen Unmöglichkeiten – sie sind die Signatur eines Prozesses, der von der Pflicht zur Darstellung befreit ist. Was das Netzwerk produziert, wenn Realismus nicht zur Debatte steht.
Dies ist keine Verteidigung der Schlampigkeit. Die Unvollkommenheiten tragen Information. Ein verwandeltes Gesicht sagt etwas darüber aus, wie das Modell Gesichtsstruktur kodiert – welche Merkmale es für tragend hält, welche es abdriften lässt. Eine räumliche Unmöglichkeit sagt etwas darüber aus, wie das Netzwerk ohne explizite 3D-Modellierung mit Tiefe umgeht. Die Artefakte sind eine Auslesung der inneren Geometrie des Modells, sichtbar geworden gerade deshalb, weil die Guidance niedrig genug ist, um den latenten Raum sich ausdrücken zu lassen.
Die Ästhetik des Projekts steht der Radiografie näher als der Malerei. Die Bilder zeigen, wie ein Netzwerk visuelle Information verarbeitet, wenn das Sehen uneingeschränkt ist – der latente Raum, der sich durch die Artefakte ausdrückt.
Die Frage der Autorschaft
In den meisten Texten über KI-Kunst gibt es einen defensiven Reflex: das Beharren darauf, dass der Mensch der eigentliche Autor sei, die KI bloß ein Werkzeug und sich an kreativer Handlungsmacht nichts Grundlegendes geändert habe. Dieser Reflex ist verständlich. Er ist auch unzureichend.
Die ehrliche Beschreibung: Die handgezeichnete Skizze stammt vom Autor. Der Zweiwort-Prompt stammt vom Autor. Die Parameterentscheidungen stammen vom Autor. Die Auswahl – Stunden der Entscheidung, welche Bilder überleben und welche verworfen werden – stammt unzweideutig vom Autor. Die Bilder selbst werden von einem System produziert, dessen innere Abläufe undurchsichtig sind, dessen Ausgaben sich aus seinen Eingaben nicht vorhersagen lassen, dessen „Entscheidungen“ statistisch sind.
Die ehrlichere Beschreibung: Der Autor setzt die Bedingungen. Das Netzwerk generiert innerhalb dieser Bedingungen. Der Autor wählt aus der Generierung aus. Die Autorschaft verteilt sich über das Setzen, das Generieren und das Auswählen – und das Generieren ist der eine Teil, den der Autor nicht kontrolliert.
So entsteht die Arbeit. Das entspricht einem Verständnis kreativer Arbeit, das älter ist als das romantische Modell des einsamen Genies: Dinge herzustellen bedeutet, sich Prozessen zu unterwerfen, die man nicht vollständig kontrolliert – der Maserung des Holzes, der Chemie der Glasur, dem Widerstand des Steins. Die Arbeit entsteht in der Begegnung zwischen Absicht und Material.
Der Unterschied bei KI ist der Maßstab. Das Material ist nicht passiv. Es interpoliert. Es halluziniert. Es führt Struktur ein, die der Autor nicht angefordert hat. Die Begegnung ist aktiver, das Material generativer als Holz oder Stein. Doch die Struktur der Begegnung – Bedingungen setzen, sich auf Material einlassen, Ergebnisse auswählen – ist dieselbe Struktur wie seit jeher.
Technische Parameter, Prozessdokumentation und die vollständige neunteilige Serie sind auf der Projektseite verfügbar. Ausgewählte Editionen auf mintbase.xyz erhältlich. Nachtrag: mintbase.xyz wurde eingestellt. Wie ironisch.
Referenzen: Stable Diffusion v1.5 (Rombach et al., 2022). ControlNet (Zhang & Agrawala, 2023). ResNet50 (He et al., 2016). TensorFlow image similarity pipeline. Adobe AfterEffects time-warp interpolation.
Serie I
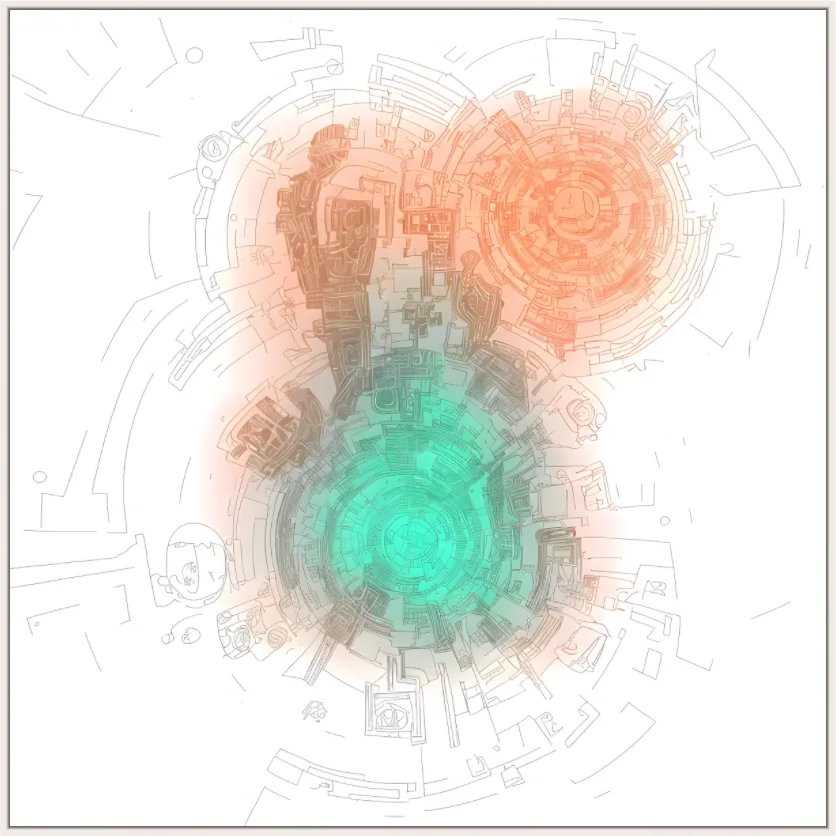
Serie II
Serie III
Serie IV